

Spider van een zoekmachine
Een spider van een zoekmachine is een geautomatiseerde bot die webpagina's crawlt om inhoud te indexeren voor zoekmachines zoals Google en Bing. Lees hoe ze wer...
10 min lezen
SEO
DigitalMarketing
+3
Spiderdetectie is het proces van het identificeren van geautomatiseerde softwareprogramma’s — spiders, webcrawlers of bots genoemd — die een website bezoeken, en bepalen of elk daarvan een legitiem doel dient of een bedreiging vormt voor de gegevensintegriteit, advertentie-uitgaven of inkomsten van het affiliateprogramma.
Spiderdetectie is het proces van het identificeren van geautomatiseerde softwareprogramma’s — spiders, webcrawlers of bots genoemd — die een website bezoeken, en bepalen of elk daarvan een legitiem doel dient of een bedreiging vormt voor de gegevensintegriteit, advertentie-uitgaven of inkomsten van het affiliateprogramma.
Spiderdetectie is een beveiligings- en analysediscipline die geautomatiseerde HTTP-clients identificeert door hun technische kenmerken, gedragspatronen en netwerkeigenschappen te onderzoeken. De term “spider” komt van hoe deze programma’s het web crawlen — hyperlinks volgen van pagina naar pagina, zoals een spin zijn web doorkruist.
In de praktijk beantwoordt spiderdetectie voor elke bezoeker één vraag: is dit een mens, een vriendelijke bot of een kwaadaardig script? Het antwoord bepaalt of het bezoek wordt meegeteld in je analytics, of de klik een commissie activeert en of de lead in je CRM terechtkomt.
De drie termen worden vaak door elkaar gebruikt, maar hebben verschillende connotaties, afhankelijk van de context:
Niet al het geautomatiseerde verkeer is vijandig. Effectieve spiderdetectie maakt onderscheid tussen categorieën:
| Botcategorie | Voorbeelden | Moet je blokkeren? |
|---|---|---|
| Zoekmachinecrawlers | Googlebot, Bingbot, YandexBot | Nee — blokkeren verwijdert je uit zoekresultaten |
| SEO- en marketingtools | AhrefsBot, SemrushBot, Moz Dotbot | Per geval — ze verbruiken bronnen maar kunnen zichtbaarheid helpen |
| Monitoring en validatie | IAB Tech Lab-crawler, uptimemonitors | Nee — ze verifiëren ads.txt, SSL en sitestatus |
| Content scrapers | Ongeïdentificeerde bots die je inhoud kopiëren | Ja — ze stelen inhoud en bieden geen waarde |
| Klikfraudebots | Scripts die op affiliate-links of advertenties klikken | Ja — ze stelen direct uit je budget |
| Leadsfraudebots | Geautomatiseerde formulieren die nepinschrijvingen indienen | Ja — ze verspillen CPA-uitgaven en vervuilen je CRM |
| Credential stuffers | Bots die gestolen inloggegevens testen | Ja — ze vormen een beveiligingsrisico |
De grens tussen “goed” en “slecht” is niet altijd scherp. Een SEO-crawler van een legitieme tool kan nog steeds je analytics vertekenen als je zijn bezoeken als menselijk verkeer telt. Spiderdetectie geeft je de gegevens om weloverwogen beslissingen te nemen, niet om alles klakkeloos te blokkeren.

Stel geavanceerde tracking in binnen enkele minuten. Geen creditcard vereist.
Moderne spiderdetectie combineert meerdere signalen. Geen enkele controle is op zichzelf betrouwbaar — geavanceerde bots vervalsen user-agents, wisselen IP’s en bootsen menselijk gedrag na. Effectieve detectie combineert verschillende methoden.
Elk HTTP-verzoek bevat een User-Agent-header die de client identificeert die het verzoek doet. Legitieme crawlers geven zich openlijk op:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 (compatible; Bingbot/2.0; +http://www.bing.com/bingbot.htm)
Beperking: Elke bot kan beweren Googlebot te zijn door de user-agent-string te kopiëren. User-agent-analyse is een eerste filter, geen definitieve controle.
De betrouwbare manier om een beweerde crawler-identiteit te verifiëren, is door het IP-adres te controleren. Voor grote zoekmachines werkt dit proces als volgt:
*.googlebot.com voor Googlebot).Als alle vier stappen overeenkomen, is de crawler authentiek. Google, Bing en Yandex publiceren allemaal hun IP-bereiken en verificatiemethoden. Elke bot die beweert Googlebot te zijn maar verbinding maakt vanaf een AWS-datacenter-IP wordt onmiddellijk gemarkeerd.
Mensen surfen onvoorspelbaar. Ze pauzeren tussen paginaweergaven, scrollen met variabele snelheid en klikken in patronen die moeilijk programmatisch te reproduceren zijn. Bots laten andere vingerafdrukken achter:
Gedragssignalen zijn moeilijker te vervalsen dan headers of IP’s. Ze vereisen dat de botoperator menselijke interactie simuleert, wat de kosten en complexiteit van de aanval verhoogt om veel fraudeurs af te schrikken.
Device fingerprinting verzamelt kenmerken van de verbindende client — browserversie, geïnstalleerde lettertypen, schermresolutie, WebGL-renderer en tientallen andere signalen — om een unieke identificatie te maken. Wanneer dezelfde fingerprint verschijnt bij honderden “verschillende” bezoekers, of wanneer een fingerprint niet overeenkomt met de opgegeven user-agent, markeren spiderdetectiesystemen het verkeer.
| Methode | Wat het controleert | Sterkte | Zwakte |
|---|---|---|---|
| User-agent-analyse | Browser-/client-ID-string | Snel, kosteloos eerste filter | Gemakkelijk te vervalsen |
| IP-/reverse DNS-verificatie | Netwerkherkomst en hostnaamovereenkomst | Overtuigend voor bekende crawlers | Werkt alleen voor bekende bots |
| Gedragsanalyse | Verzoektiming, navigatiepatronen | Moeilijk te vervalsen op schaal | Vereist sessiegegevens |
| Device fingerprinting | Browser- en hardwarekenmerken | Sterk fraudesignaal | Privacyregelgeving kan van toepassing zijn |
| JavaScript-uitdagingen | Vermogen om scripts uit te voeren | Blokkeert eenvoudige scripts | Legitieme crawlers draaien mogelijk geen JS |
| Honeypot-vallen | Verborgen links die alleen bots volgen | Hoge betrouwbaarheid botdetectie | Vereist site-instrumentatie |
Affiliateprogramma’s betalen partners voor prestaties — klikken, leads of verkopen. Elke frauduleuze gebeurtenis die als legitiem wordt geteld, kost echt geld. Spiderdetectie is de eerste verdedigingslinie tegen verschillende vormen van affiliatefraude.
Klikfraude is de meest directe aanval op affiliatebudgetten. Een bot simuleert klikken op affiliate-links, waardoor klikstatistieken worden opgeblazen zonder enige menselijke betrokkenheid. De affiliate krijgt betaald voor verkeer dat nooit een kans had om te converteren.
Spiderdetectie onderschept klikfraude door de geautomatiseerde patronen achter de klikken te identificeren: datacenter-IP’s, herhaalde klikken van identieke device fingerprints en kliksnelheden die geen mens kan produceren.
In cost-per-lead (CPL) affiliateprogramma’s dienen bots nepaanmeldingsformulieren in om commissie-uitbetalingen te activeren. Deze leads zien er op het eerste gezicht echt uit — ze hebben namen, e-mailadressen en telefoonnummers — maar ze converteren nooit verder.
Spiderdetectie markeert nepleads door te controleren of de inzending afkomstig is van een datacenter-IP, een vervalst apparaat of een wegwerp-e-maildomein — signalen die een menselijke gebruiker zelden zou produceren.
Cookie stuffing is een subtielere vorm van fraude. Een script plaatst affiliate-trackingcookies op de browser van een gebruiker zonder diens medeweten — vaak via een pop-under, een 1×1 pixelafbeelding of een script dat in een gecompromitteerde pagina wordt geïnjecteerd. Wanneer die gebruiker later een aankoop doet, claimt de fraudeur de commissie.
Spiderdetectie identificeert de geautomatiseerde scripts die cookie stuffing uitvoeren aan hun gedragskenmerk: snelle, onzichtbare verzoeken die cookies plaatsen zonder bijbehorend paginabezoek of gebruikersinteractie.
Naast direct financieel verlies vervuilt botverkeer elke statistiek waarop je vertrouwt. Conversieratio’s dalen omdat botverkeer je noemer opblaast. Campagneprestaties worden onleesbaar. Marketingteams optimaliseren voor cohorten die nooit hebben bestaan.
Schone spiderdetectie herstelt het vertrouwen in je gegevens. Wanneer je botverkeer filtert voordat het je analytics bereikt, zie je wat je menselijke gebruikers werkelijk doen — en kun je beslissingen nemen op basis van de realiteit.
Wees de eerste die op de hoogte is van nieuwe functies en productupdates.
Het Interactive Advertising Bureau (IAB) Tech Lab onderhoudt de industriestandaardreferentie voor spiderdetectie: de IAB/ABC International Spiders and Bots List. Het is de basis waarop de meeste serieuze fraudepreventiesystemen zijn gebouwd.
De lijst bestaat uit twee tekstbestanden die regelmatig worden bijgewerkt:
De IAB schrijft een tweestapsaanpak voor, gedefinieerd in de Ad Impression Measurement Guidelines:
Deze tweestapsmethode is de standaard voor MRC-geaccrediteerde detectie van ongeldig verkeer (IVT). Het zorgt ervoor dat aangegeven crawlers worden uitgefilterd, terwijl onbekende bots niet onopgemerkt doorglippen simpelweg omdat ze niet op een lijst staan.
Toegang vereist een ondertekende data-abonnementsovereenkomst en wordt verstrekt via de Tech Lab Tools Portal. Eén accountlogin per abonnerend bedrijf. Voor de meeste affiliateprogrammabeheerders wordt de lijst indirect benaderd — via het fraudedetectieplatform of de analysetool die ze al gebruiken, die de lijst namens hen in licentie heeft.
Deze ingebouwde systemen filteren botverkeer automatisch uit je rapporten, zodat klikken en conversies die aan bekende crawlers worden toegeschreven, nooit in je commissieberekeningen terechtkomen.
Het voordeel van detectie op platformniveau is dat er geen installatie nodig is — het werkt direct uit de doos, wordt onderhouden door de leverancier en heeft de IAB-lijst geïntegreerd.
Voor programma’s met een hogere fraudeblootstelling — grote CPA-uitbetalingen, hoge verkeersvolumes of branches die door frauderingen worden getarget — voegen speciale fraudepreventieplatforms extra lagen toe bovenop basis spiderdetectie:
Zelfs zonder een speciaal platform kunnen programmabeheerders verschillende signalen handmatig monitoren:
Een spiderval is een reeks dynamisch gegenereerde pagina’s die een oneindige lus creëren voor webcrawlers. Veelvoorkomende voorbeelden zijn:
Een legitieme crawler die een spiderval tegenkomt, kan zijn crawlbudget verbranden — het aantal pagina’s dat het aan je site toewijst — door duizenden bijna-identieke pagina’s te indexeren terwijl het je werkelijke inhoud mist.
Spidervallen schaden je site op twee manieren. Ten eerste verspillen ze crawlbudget: Googlebot besteedt zijn toewijzing aan betekenisloze URL’s in plaats van aan je productpagina’s en blogberichten. Ten tweede kunnen ze de serverprestaties verslechteren doordat crawlers dynamisch gegenereerde pagina’s bestoken.
De oplossing is eenvoudig: gebruik robots.txt om crawlen van voor valgevoelige URL-patronen te verbieden, voeg rel="canonical"-tags toe om dubbele pagina’s samen te voegen en voorkom blootstelling van oneindige URL-ruimtes via interne links. Spiderdetectiesystemen kunnen ook identificeren wanneer een bekende crawler vastzit in een val en de toegang dienovereenkomstig beperken.
Beveilig je affiliatecampagnes en gegevensintegriteit met geavanceerde spiderdetectietools en fraudepreventiestrategieën.
Een spider van een zoekmachine is een geautomatiseerde bot die webpagina's crawlt om inhoud te indexeren voor zoekmachines zoals Google en Bing. Lees hoe ze wer...
+++ term = “Wat is een zoekmachinecrawler?” lastmod = “2026-10-08” title = “Wat is een zoekmachinecrawler?” keywords = [ &ld...
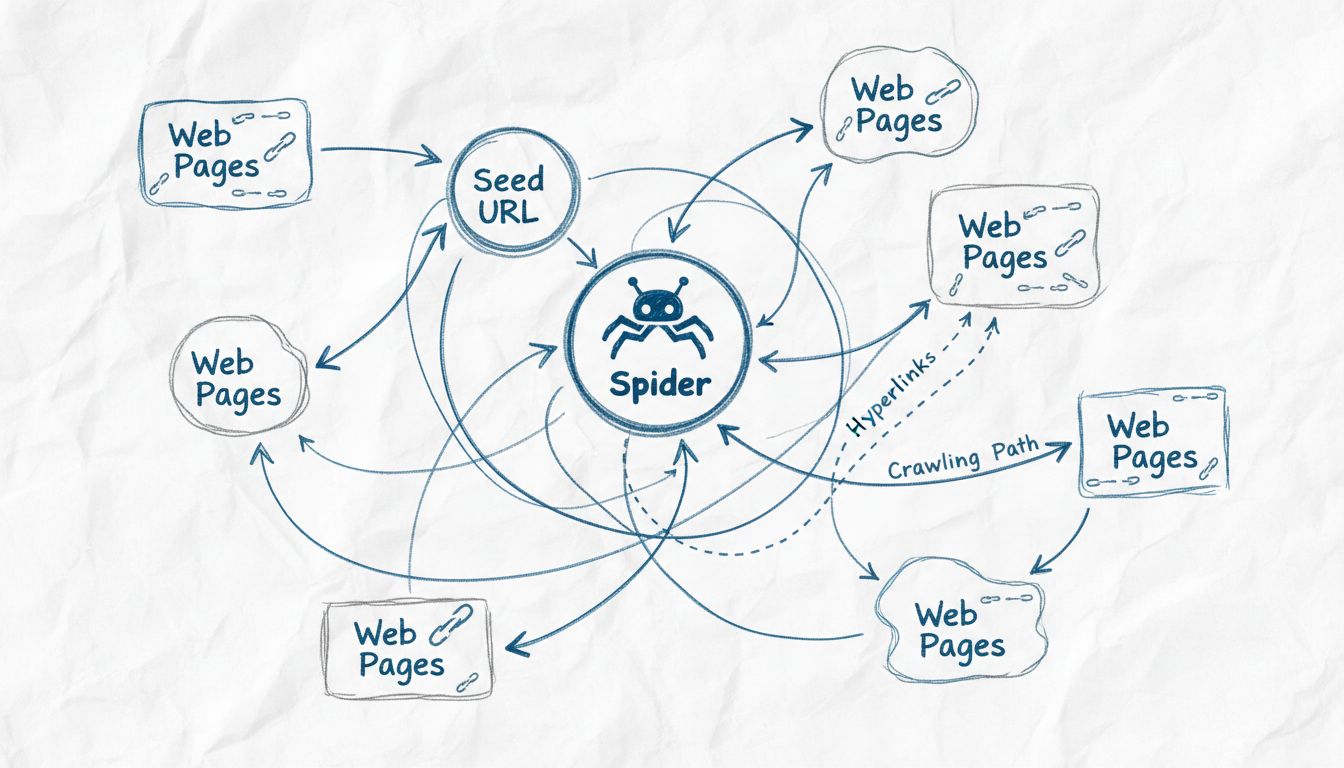
Ontdek waarom webcrawlers 'spiders' worden genoemd, hoe ze werken en hun cruciale rol in zoekmachine-indexering. Leer de technische mechanismen achter webcrawli...
Sluit u aan bij onze gemeenschap van tevreden klanten en bied uitstekende klantenservice met Post Affiliate Pro.
Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.