


Spider van een zoekmachine
Een spider van een zoekmachine is een geautomatiseerde bot die webpagina's crawlt om inhoud te indexeren voor zoekmachines zoals Google en Bing. Lees hoe ze wer...
10 min lezen
SEO
DigitalMarketing
+3
Een zoekmachinecrawler is een geautomatiseerd softwareprogramma — ook wel bot, spider of spiderbot genoemd — dat systematisch het World Wide Web doorzoekt, pagina-inhoud downloadt en hyperlinks volgt om nieuwe of bijgewerkte URL’s te ontdekken.
Een zoekmachinecrawler is een geautomatiseerd softwareprogramma — ook wel een bot, spider of spiderbot genoemd — dat systematisch het World Wide Web doorzoekt, pagina-inhoud downloadt en hyperlinks volgt om nieuwe of bijgewerkte URL’s te ontdekken. De kerntaak is het voeden van de index van een zoekmachine met actuele gegevens, zodat wanneer iemand een zoekopdracht invoert, de engine relevante en actuele resultaten kan tonen. Zonder crawlers heeft een zoekmachine geen manier om te weten dat een pagina bestaat.
De crawler zelf rangschikt niets. Het ontdekt en geeft wat het vindt — tekst, links, metadata, afbeeldingen — door aan een apart indexerings- en rankingsysteem. Crawlen, indexeren en ranken zijn drie afzonderlijke fasen. Een pagina kan worden gecrawld en toch nooit in zoekresultaten verschijnen als deze niet voldoet aan de kwaliteitsdrempels van de engine tijdens het indexeren.
De crawlerdocumentatie van Google maakt onderscheid tussen de gewone crawlers, speciale crawlers en door gebruikers geactiveerde fetchers. Raadpleeg de gedocumenteerde identiteit en het gedrag van de relevante crawler bij het onderzoeken van toegangsproblemen.
Op deze pagina
Een webcrawler werkt in een continue cyclus rond een aantal kernstappen. Inzicht in deze stappen helpt website-eigenaren te diagnosticeren waarom pagina’s mogelijk niet in zoekresultaten verschijnen — het probleem zit vaak in de crawlfase, lang voordat ranken zelfs wordt overwogen.
Elke crawler begint met een reeks bekende URL’s, start-URL’s genoemd. Deze kunnen afkomstig zijn van eerder gecrawlde pagina’s, ingediende sitemaps of handmatig gekozen startpunten. De crawler downloadt elke startpagina, extraheert alle hyperlinks die hij vindt en voegt elke nog niet eerder geziene link toe aan een wachtrij, de crawlfrontier genoemd.
De cyclus herhaalt zich vervolgens:
Deze lus eindigt nooit echt. Het web verandert voortdurend en er verschijnen elke seconde nieuwe pagina’s, dus een crawler werkt gewoon door wat er als volgende in de wachtrij staat, bezoekt oude pagina’s opnieuw om te controleren op wijzigingen en voegt nieuw ontdekte URL’s toe.
Zodra een crawler een pagina ophaalt, rendert hij de inhoud — leest de HTML, voert waar mogelijk JavaScript uit en extraheert de tekst, afbeeldingen, metadata en gestructureerde gegevens. Vervolgens downloadt hij deze informatie en geeft deze door aan de indexeerder van de zoekmachine.
Niet elke crawler gaat even goed om met JavaScript. Googlebot rendert JavaScript en wacht op dynamisch geladen inhoud, maar kleinere zoekmachinecrawlers lezen mogelijk alleen statische HTML. Dit is de reden waarom sites die volledig zijn gebouwd met client-side JavaScript-frameworks onzichtbaar kunnen zijn voor sommige zoekmachines, tenzij server-side rendering is geïmplementeerd.
Crawlers ontdekken nieuwe pagina’s via twee primaire kanalen:

Stel geavanceerde tracking in binnen enkele minuten. Geen creditcard vereist.
Crawlers behandelen niet alle pagina’s gelijk. Ze werken onder een reeks crawlbeleidsregels die bepalen welke pagina’s ze bezoeken, in welke volgorde en hoe vaak ze terugkeren.
Een crawler moet beslissen welke URL’s hij prioriteit geeft vanuit zijn crawlfrontier. Veelvoorkomende signalen zijn:
Hoe vaak een crawler terugkeert naar een pagina hangt af van hoe vaak die pagina verandert. Een nieuwsstartpagina kan elke paar minuten worden gecrawld. Een statische ‘Over ons’-pagina wordt misschien eens in de paar maanden opnieuw bezocht. Webmasters kunnen de wijzigingsfrequentie aangeven via XML-sitemap <changefreq>-tags, hoewel zoekmachines deze als hints behandelen, niet als opdrachten.
Crawlers zijn geprogrammeerd om webservers niet te overbelasten. Ze respecteren een crawlrate-limiet — het maximale aantal verzoeken dat ze naar een enkele site in een bepaalde periode sturen. Als een server reageert met HTTP-fouten zoals 500 of 503, trekt de crawler zich terug om het probleem niet te verergeren. Dit is een van de redenen waarom crawlen op grote schaal een echte technische uitdaging is.
Het robots.txt-bestand is een platte-tekstdocument dat in de root van een domein wordt geplaatst en crawlers vertelt welke URL’s ze wel en niet mogen opvragen. Het is het belangrijkste hulpmiddel voor het beheren van crawler-toegang. Een robots.txt-invoer kan er als volgt uitzien:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ over te slaan, maar staat alles onder /public/ toe. Andere crawlers controleren hetzelfde bestand en volgen hun eigen User-agent-richtlijnen. Het is belangrijk op te merken dat robots.txt een vrijwillig protocol is — goedgemanierde crawlers volgen het, maar kwaadaardige bots kunnen het volledig negeren.Crawlbudget is het aantal pagina’s dat een zoekmachine binnen een bepaalde periode op een site zal crawlen. Het wordt bepaald door twee factoren:
Voor kleine sites is crawlbudget zelden een zorg. Voor grote ecommerce-platforms of contentsites met miljoenen URL’s wordt het beheren van crawlbudget essentieel — verspilde crawls aan dubbele inhoud, gefacetteerde navigatieparameters of pagina’s met weinig waarde betekenen minder middelen voor de pagina’s die er echt toe doen.
Elke grote zoekmachine heeft zijn eigen crawler met een duidelijke user-agentstring — een identificatie die de bot met elk HTTP-verzoek meestuurt, zodat servers weten welke crawler op bezoek is.
| Zoekmachine | Crawlernaam | User-Agent-identificatie | Doel |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Crawlt en indexeert webpagina’s voor Google Zoeken en andere Google-diensten | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Crawlt en indexeert pagina’s voor Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Crawlt pagina’s voor de zoekresultaten van DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Crawlt pagina’s voor Yandex Zoeken (dominant in Rusland) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Crawlt pagina’s voor Baidu Zoeken (dominant in China) |
| Apple | Applebot | Applebot/1.0 | Crawlt pagina’s voor Spotlight Zoeken en Siri-suggesties |
Google heeft ook gespecialiseerde crawlers voor verschillende inhoudstypen — Googlebot Image crawlt afbeeldingen, Googlebot Video verwerkt video-inhoud, Googlebot News richt zich op nieuwsartikelen en AdsBot controleert de kwaliteit van landingspagina’s voor Google Ads.
Wees de eerste die op de hoogte is van nieuwe functies en productupdates.
Het identificeren of een bezoeker echt Googlebot is, vereist meer dan alleen het controleren van een user-agentstring, aangezien deze strings kunnen worden vervalst. Om een Google-crawler te verifiëren:
Googlebot.googlebot.com- of google.com-domein.Google biedt officiële documentatie met de IP-reeksen op google.com/bot.html. Elke bezoeker die beweert Googlebot te zijn maar deze verificatiestappen niet doorstaat, is een vervalste bot en moet als verdacht worden behandeld.
Ja — maar met beperkingen. Grote zoekmachines hebben speciale crawlers voor niet-tekstuele inhoud:
VideoObject-schema om titel, beschrijving, miniatuur en duur te begrijpen.Crawlers kunnen afbeeldingen echter niet ‘zien’ zoals een mens dat doet of video’s ‘kijken’. Ze vertrouwen volledig op tekstuele signalen — bestandsnamen, alt-attributen, bijschriften, omliggende hoofdtekst en gestructureerde gegevens — om relevantie te bepalen. Inhoud die verborgen zit achter inlogmuren, betaalmuren of is ingebed in complexe JavaScript-spelers, wordt mogelijk helemaal niet gecrawld.
Deze termen worden vaak door elkaar gebruikt, maar beschrijven verschillende dingen:
| Aspect | Webcrawler | Webscraper |
|---|---|---|
| Doel | URL’s ontdekken en indexeren over het hele web | Specifieke gegevens extraheren van gerichte pagina’s |
| Bereik | Breed — volgt links overal | Smal — richt zich op bekende URL’s of domeinen |
| Output | Voedt een zoekindex | Produceert gestructureerde gegevens (CSV, database, spreadsheet) |
| Typische operator | Zoekmachines (Google, Bing) | Bedrijven, onderzoekers, gegevensanalisten |
| Respecteert robots.txt | Ja (legitieme crawlers) | Wisselend — veel scrapers negeren het |
| Voorbeelden | Googlebot, Bingbot | Prijsmonitoringtools, leadgeneratie-scrapers, AI-trainingsdataverzamelaars |
Zoekmachines vinden nieuwe pagina’s via verschillende kanalen:
De snelste weg om een nieuwe pagina te laten crawlen, is door de URL rechtstreeks in te dienen via Search Console en ervoor te zorgen dat deze is gelinkt vanaf een reeds geïndexeerde pagina op dezelfde site.
Er is geen vast schema. De herhalingsfrequentie hangt af van:
Site-eigenaren kunnen de herhalingsfrequentie beïnvloeden door regelmatig content te publiceren, snelle serverrespons tijden te handhaven en bijgewerkte sitemaps in te dienen. Maar uiteindelijk bepaalt de crawler zijn eigen schema op basis van de signalen die hij waarneemt.
Crawlers hebben over het algemeen geen toegang tot:
Een crawler ziet alleen wat openbaar toegankelijk en gelinkt is. Als een pagina authenticatie of gebruikersinteractie vereist om te worden weergegeven, is deze effectief onzichtbaar voor zoekmachines — tenzij de site-eigenaar expliciet toegang verleent of een alternatief pad biedt, zoals een sitemap met de URL in combinatie met gestructureerde gegevens die de inhoud beschrijven.
Het bouwen van een crawler die werkt voor een paar honderd pagina’s is eenvoudig. Het bouwen van een crawler die werkt voor miljarden pagina’s is een heel ander probleem. Veelvoorkomende faalpunten zijn:
Voor de meeste bedrijven is het runnen van een grootschalige webcrawler niet praktisch zonder beheerde infrastructuur. De beslissing komt meestal neer op het gebruiken van een bestaande tool in plaats van zelf te bouwen.
In de Verenigde Staten is het crawlen van openbaar toegankelijke webpagina’s over het algemeen legaal. Verschillende rechterlijke uitspraken — waaronder *hiQ Labs v.
De legaliteit hangt echter af van verschillende factoren:
Het onderscheid tussen crawlen voor zoekindexering (algemeen geaccepteerd) en scrapen voor commerciële gegevensextractie (juridisch meer omstreden) is belangrijk. De meeste legitieme zoekmachinecrawlers opereren in duidelijk legaal terrein.
Nee — ChatGPT zelf is geen webcrawler. ChatGPT is een conversationeel AI-model dat antwoorden genereert. OpenAI heeft echter wel een aparte webcrawler genaamd GPTBot, die openbare webpagina’s crawlt om trainingsgegevens te verzamelen voor AI-modellen en om live-opzoekingsfuncties in sommige OpenAI-producten te ondersteunen.
GPTBot identificeert zich met de user-agenttoken GPTBot en respecteert robots.txt-richtlijnen. Site-eigenaren die GPTBot specifiek willen blokkeren, kunnen het volgende toevoegen aan hun robots.txt-bestand:
User-agent: GPTBot
Disallow: /
Zoekmachinecrawlers hebben direct invloed op iedereen in het affiliate marketing-ecosysteem. Als een pagina niet wordt gecrawld, scoort deze niet, en als deze niet scoort, genereert deze geen organisch verkeer — en dus geen affiliate-inkomsten.
De contentsite van een uitgever staat of valt met crawlbaarheid. Elke productreview, vergelijkingsgids of aanbiedingenoverzicht moet vindbaar zijn voor crawlers. Veelvoorkomende fouten van uitgevers die crawling blokkeren zijn:
Uitgevers moeten controleren of hun meest waardevolle pagina’s verschijnen in het indexdekkingsrapport van Google Search Console en dat er geen noindex-tags of robots.txt-regels zijn die ze onbedoeld blokkeren.
Een adverteerder die een affiliateprogramma runt, heeft nodig dat zijn productpagina’s worden gecrawld en geïndexeerd, zodat uitgevers kunnen linken naar live, zichtbare pagina’s. Als de productpagina’s van een handelaar niet in de index van Google staan, hebben uitgevers geen plek om verkeer naartoe te sturen. Specifieke risico’s zijn:
Handelaren moeten schone URL-structuren onderhouden, productsitemaps indienen en crawlstatistieken in Search Console monitoren om problemen te signaleren voordat ze partneruitgevers beïnvloeden.
Programmabeheerders staan tussen handelaren en uitgevers in en moeten het gedrag van crawlers begrijpen om zichtbaarheidsproblemen op te lossen. Wanneer een uitgever meldt dat een productpagina van een handelaar ’niet verschijnt in Google’, is het probleem vaak een crawl- of indexeringsprobleem — niet een rankingsprobleem. Praktische stappen zijn:
site:-zoekoperator van Google.Een programmabeheerder die basis crawlproblemen kan diagnosticeren, voegt directe waarde toe aan beide kanten van de affilaterelatie — handelaren helpen technische problemen op te lossen en uitgevers helpen bevestigen dat de pagina’s die ze promoten vindbaar zijn.
Leer hoe inzicht in en optimalisatie voor crawlers de zichtbaarheid en zoekmachineranking van je website kunnen verbeteren.
Een spider van een zoekmachine is een geautomatiseerde bot die webpagina's crawlt om inhoud te indexeren voor zoekmachines zoals Google en Bing. Lees hoe ze wer...
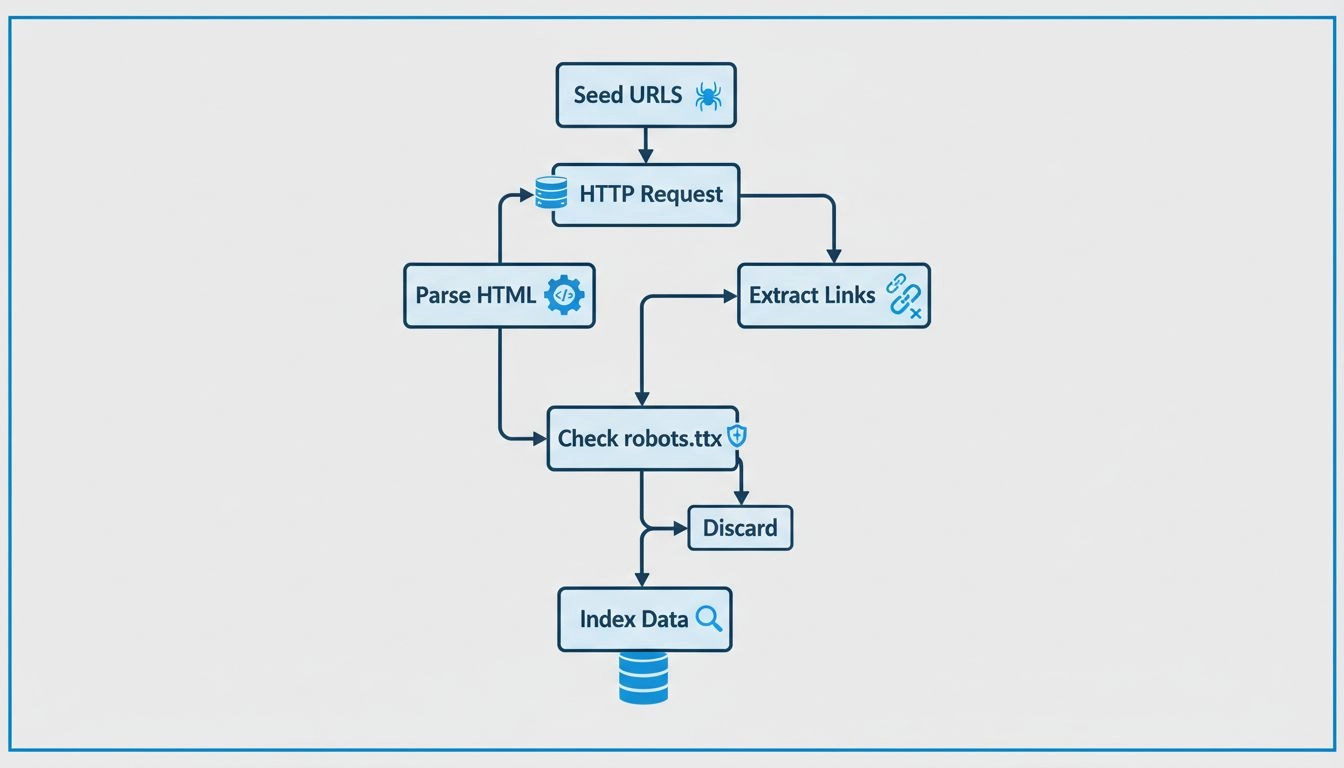
Leer hoe webcrawlers werken, van seed-URL's tot indexering. Begrijp het technische proces, de verschillende typen crawlers, robots.txt-regels en hoe crawlers SE...
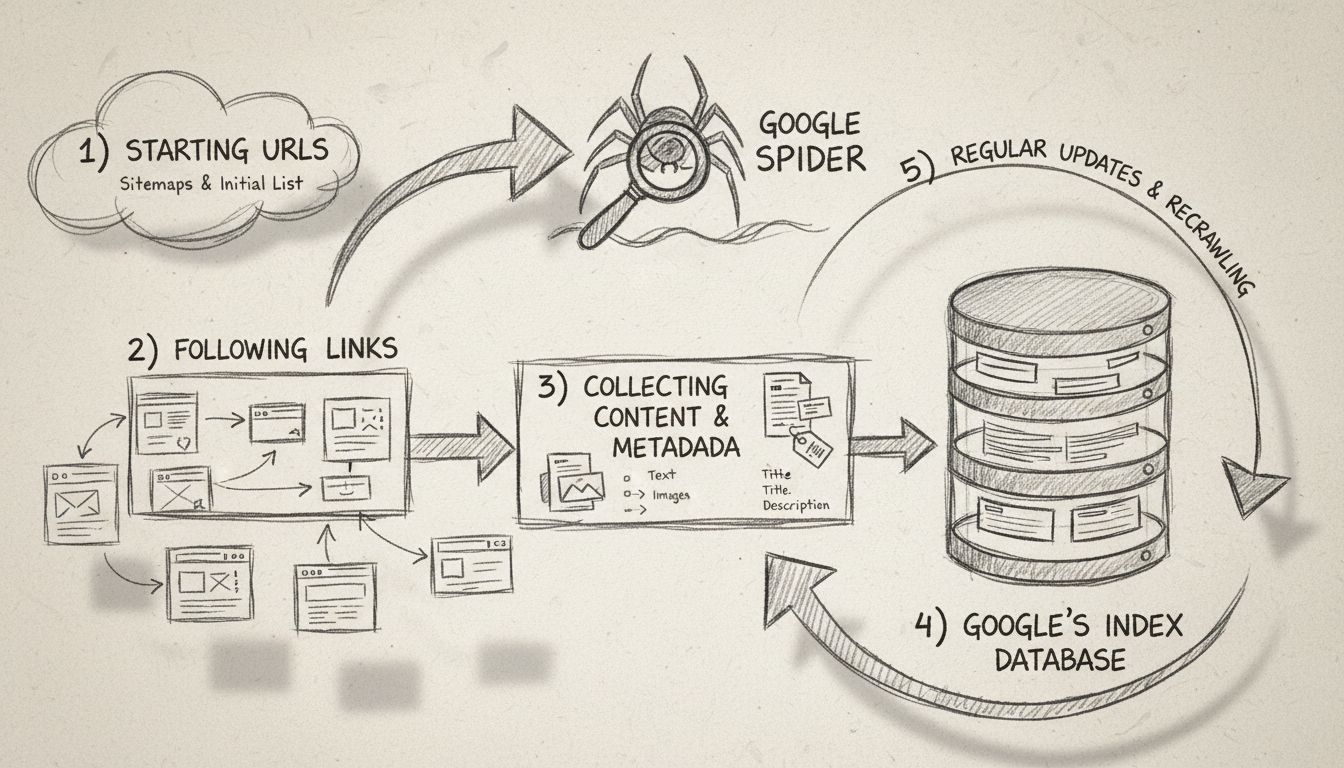
Leer wat de Google Spider (Googlebot) is, hoe deze websites crawlt en indexeert, en waarom dit essentieel is voor SEO. Ontdek hoe je jouw site kunt optimalisere...
Sluit u aan bij onze gemeenschap van tevreden klanten en bied uitstekende klantenservice met Post Affiliate Pro.


Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.