


Hoe werken webcrawlers? Complete technische gids
Leer hoe webcrawlers werken, van seed-URL's tot indexering. Begrijp het technische proces, de verschillende typen crawlers, robots.txt-regels en hoe crawlers SE...
8 min lezen
Ontdek waarom webcrawlers spinnen worden genoemd, hoe ze werken en hun cruciale rol bij zoekmachine-indexering. Verken de technische mechanismen achter webcrawling in 2025.
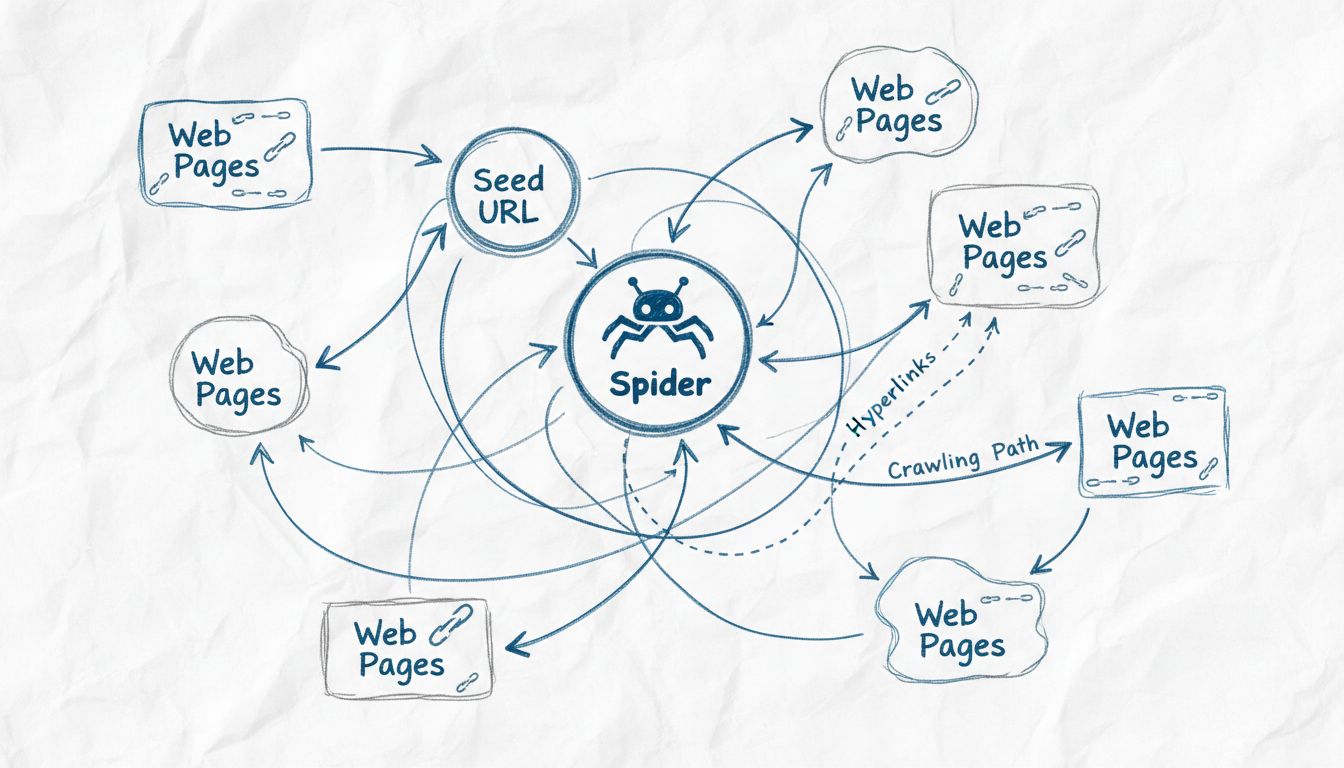
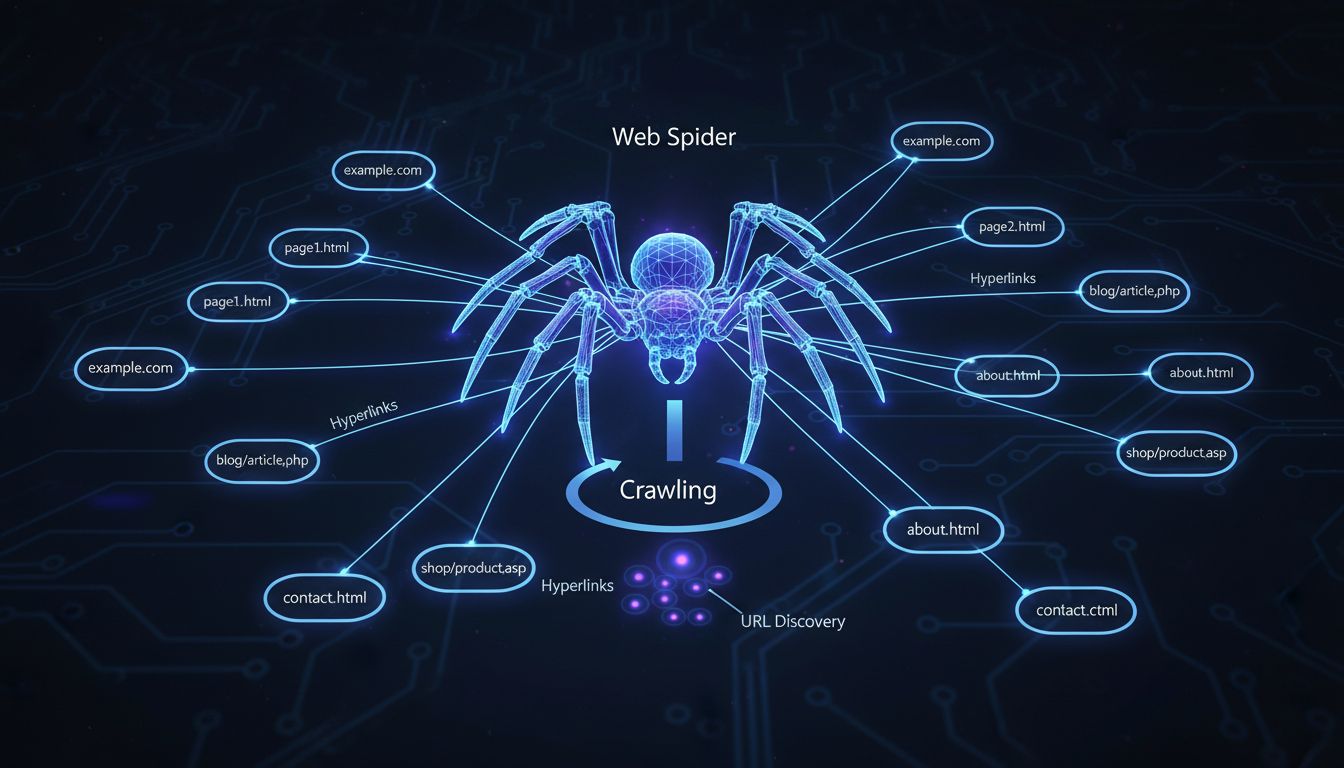
Webcrawlers worden spinnen genoemd omdat ze systematisch door het web kruipen en links van de ene pagina naar de andere volgen, vergelijkbaar met hoe een spin door zijn web beweegt. De term 'spin' is een passende metafoor voor deze geautomatiseerde bots die het onderling verbonden netwerk van websites doorkruisen om webinhoud te ontdekken, indexeren en organiseren voor zoekmachines.
De term “spin” voor webcrawlers komt voort uit een slimme metaforische vergelijking tussen hoe deze geautomatiseerde bots door het internet navigeren en hoe echte spinnen door hun web bewegen. Net zoals een spin een ingenieus web weeft om informatie over zijn omgeving te vangen en te ordenen, doorkruisen webcrawlers het onderling verbonden netwerk van hyperlinks op het World Wide Web om digitale inhoud te ontdekken, analyseren en ordenen. De metafoor is bijzonder treffend omdat beide entiteiten systematisch door complexe netwerken opereren en paden volgen om nieuwe bestemmingen te bereiken en informatie te verzamelen. Deze naamgeving is zo ingeburgerd in de technologie dat de termen “spin”, “crawler” en “bot” nu door elkaar worden gebruikt wanneer er over webindexeringstechnologie wordt gesproken. De visuele en conceptuele overeenkomst tussen een spinnenweb en de structuur van het internet maakt deze terminologie zowel intuïtief als memorabel voor technische professionals en gewone gebruikers.
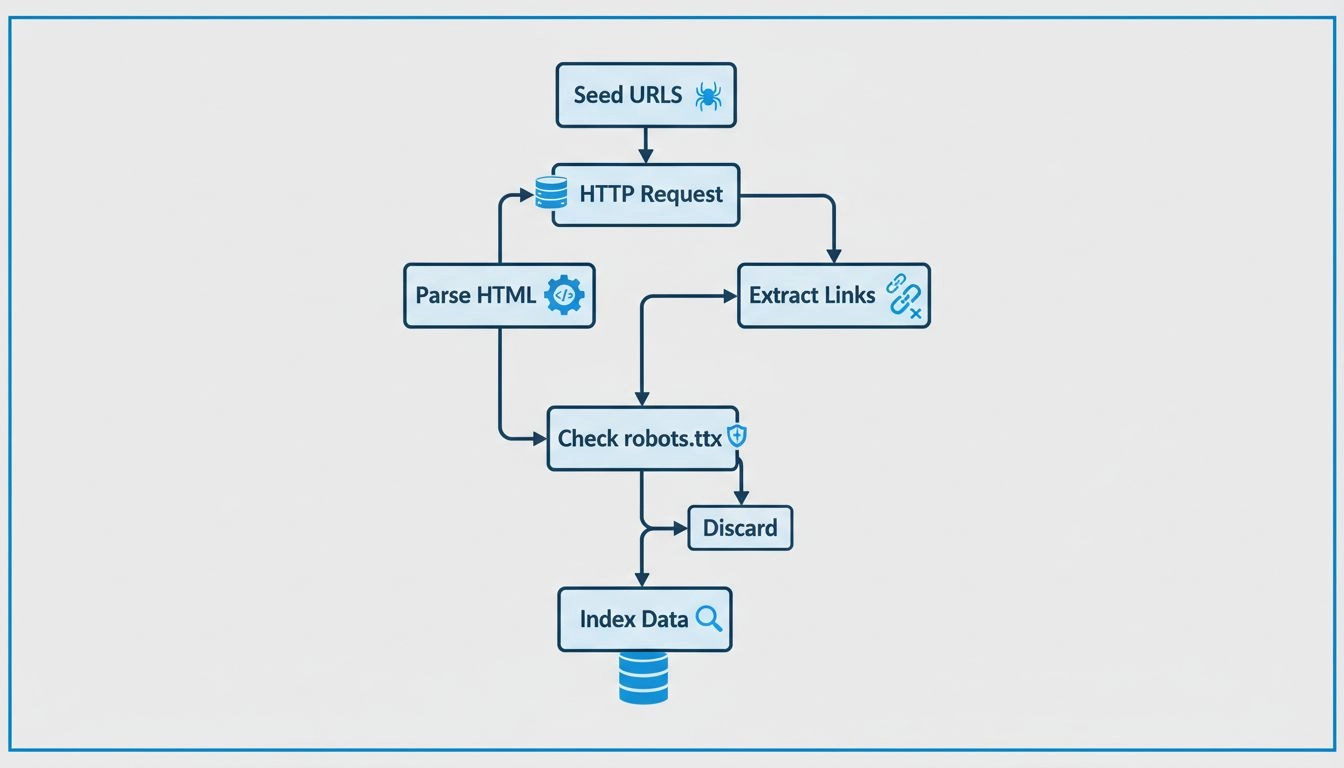
Webspinnen werken via een geavanceerd maar systematisch proces dat begint met één toegangspunt, een zogenaamde “seed-URL”. Vanaf deze startlocatie analyseert de spin de HTML-code van de webpagina en extraheert alle hyperlinks op die pagina. De spin volgt vervolgens deze links naar nieuwe pagina’s en herhaalt het proces continu om zijn bereik over het web uit te breiden. Deze methodische aanpak stelt spinnen in staat miljoenen onderling verbonden pagina’s te ontdekken zonder handmatige aansturing of menselijke tussenkomst. De spin onderhoudt wat een “crawl frontier” wordt genoemd, in feite een wachtrij van URL’s die zijn ontdekt maar nog niet bezocht. Op basis van specifieke crawlingbeleidsregels en algoritmen bepaalt de spin welke URL’s als volgende prioriteit krijgen, waarbij factoren zoals paginabelang, updatefrequentie en relevantie voor de indexeringsdoelen van de zoekmachine worden meegewogen.
| Crawlercomponent | Functie | Doel |
|---|---|---|
| URL-wachtrij | Bewaart lijst van pagina’s om te bezoeken | Organiseert de crawlvolgorde |
| Parser | Leest pagina-inhoud en HTML | Extraheert links en metadata |
| Indexeerder | Slaat pagina-informatie op | Maakt een doorzoekbare database |
| Planner | Bepaalt de crawlfrequentie | Beheert de toewijzing van middelen |
| User-Agent | Identificeert de crawler | Communiceert met servers |

Stel geavanceerde tracking in binnen enkele minuten. Geen creditcard vereist.
Moderne webspinnen zijn gebouwd op een geavanceerde technische architectuur waarmee ze grote hoeveelheden gegevens efficiënt kunnen verwerken. De kerncomponenten van een webcrawler zijn het URL-frontierbeheersysteem, dat URL’s voor crawling organiseert en prioriteert; het ophaalmechanisme, dat pagina-inhoud met hoge snelheid downloadt; de parsing-engine, die links en metadata uit HTML extraheert; en het indexeringssysteem, dat verwerkte informatie opslaat voor het ophalen van zoekresultaten. Webspinnen moeten ook beleefdheidsbeleid implementeren om te voorkomen dat doelservers worden overspoeld met buitensporige verzoeken, herbezoekbeleid om te bepalen hoe vaak pagina’s opnieuw moeten worden gecrawld voor updates, en selectiebeleid om te beslissen welke links het meest waardevol zijn om te volgen. Hedendaagse spinnen zijn geëvolueerd om JavaScript- en AJAX-inhoud te verwerken, hoewel ze nog steeds standaard-HTML prioriteren voor betrouwbare inhoudsontdekking. Het gedistribueerde karakter van moderne crawling betekent dat grootschalige spinnen gelijktijdig op meerdere servers werken, waardoor ze verschillende websites parallel kunnen crawlen en hun algehele efficiëntie en dekking drastisch kunnen vergroten.
Hoewel de termen “spin” en “crawler” vaak door elkaar worden gebruikt, is het belangrijk te begrijpen dat ze dezelfde technologie met verschillende naamgevingsconventies vertegenwoordigen. Webspinnen verschillen echter aanzienlijk van webscrapers, die soms met crawlers worden verward. Het belangrijkste onderscheid ligt in hun doel en reikwijdte: webcrawlers richten zich op algemene informatieverzameling over websites en hun structuur, en volgen links breed over het web om uitgebreide indexen op te bouwen. Webspinnen, wanneer ze specifiek door zoekmachines worden gebruikt, richten zich op het indexeren van tekstuele inhoud om deze doorzoekbaar en vindbaar te maken. Webscrapers daarentegen zijn precisie-instrumenten die zijn ontworpen om specifieke gegevenselementen van websites te extraheren, zoals productprijzen, contactgegevens of beoordelingen. Scrapers richten zich doorgaans op bepaalde websites of gegevenstypen in plaats van breed over het web te crawlen. Bovendien respecteren crawlers en spinnen over het algemeen robots.txt-bestanden en de servicevoorwaarden van websites, terwijl scrapers zonder dergelijke beperkingen kunnen opereren. Het begrijpen van deze verschillen is cruciaal voor website-eigenaren en ontwikkelaars die moeten beheren hoe hun inhoud door geautomatiseerde systemen wordt benaderd en geïndexeerd.
Wees de eerste die op de hoogte is van nieuwe functies en productupdates.
Webspinnen bestaan in verschillende vormen, elk ontworpen voor specifieke doeleinden en toepassingen. Zoekmachinespinnen zoals Googlebot zijn het bekendste type en worden door grote zoekmachines gebruikt om webpagina’s te ontdekken en te indexeren voor zoekresultaten. Gerichte crawlers daarentegen beperken hun bereik tot specifieke onderwerpen of delen van het internet en maken gedetailleerde indexen van niche-inhoud. Webanalysespinnen helpen webmasters hun eigen websites te monitoren door statistieken zoals sitebezoeken, gebroken links en paginaprestaties bij te houden. Prijsvergelijkingsspinnen verzamelen automatisch prijsinformatie van meerdere leveranciers, zodat vergelijkingswebsites gebruikers actuele marktgegevens kunnen bieden. E-mailvalidatiespinnen verifiëren e-mailadressen en controleren op afleveringsproblemen. Elk type spin heeft een eigen doel in het digitale ecosysteem, en het begrijpen van deze verschillen helpt website-eigenaren hun sites te optimaliseren voor de juiste crawlers.
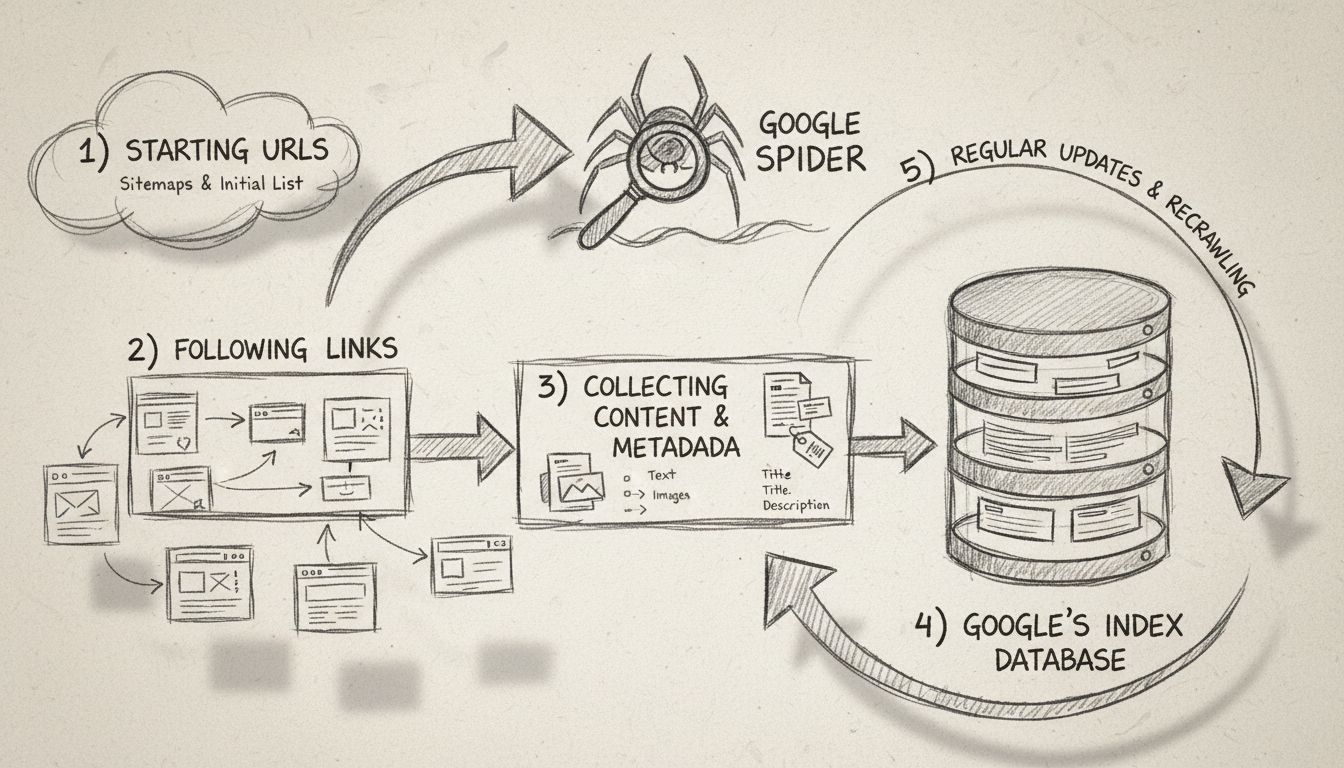
Webspinnen zijn absoluut fundamenteel voor hoe zoekmachines werken en waarde bieden aan gebruikers wereldwijd. Zonder spinnen die continu webinhoud crawlen en indexeren, zouden zoekmachines geen manier hebben om te weten welke websites bestaan, welke inhoud ze bevatten of hoe relevant die inhoud kan zijn voor zoekopdrachten van gebruikers. Wanneer een spin een webpagina crawlt, evalueert hij talrijke factoren, waaronder paginastructuur, inhoudsrelevantie, gebruik van zoekwoorden en signalen over gebruikerservaring. Deze informatie wordt vervolgens opgeslagen in enorme indexen die zoekmachines gebruiken om zoekopdrachten van gebruikers te koppelen aan de meest relevante resultaten. De kwaliteit en frequentie van het crawlen door spinnen beïnvloeden rechtstreeks hoe snel nieuwe inhoud in zoekresultaten verschijnt en hoe nauwkeurig zoekmachines pagina’s kunnen rangschikken. Zoekmachines zoals Google, Bing, Baidu en Yahoo onderhouden elk hun eigen spinnenbots—respectievelijk Googlebot, Bingbot, Baiduspider en Slurp—elk met unieke algoritmen en crawlingstrategieën die zijn geoptimaliseerd voor de specifieke doelen en gebruikersbasis van hun zoekmachine.
| Spiderbot | Zoekmachine | Hoofdfunctie | Crawlstrategie | Belangrijkste kenmerken |
|---|---|---|---|---|
| Googlebot | Webpagina’s indexeren voor Google Zoeken | Gedistribueerd crawlen met mobiele en desktopvarianten | Verwerkt JavaScript, prioriteert mobile-first indexering, respecteert crawlbudget | |
| Bingbot | Microsoft Bing | Webpagina’s indexeren voor Bing Zoeken | Parallel crawlen over meerdere servers | Efficiënt bandbreedtegebruik, respecteert robots.txt, ondersteunt meerdere inhoudstypen |
| Baiduspider | Baidu | Webpagina’s indexeren voor Baidu Zoeken | Geoptimaliseerd voor Chinese taalinhoud | Gespecialiseerd in Aziatische webinhoud, verwerkt vereenvoudigd en traditioneel Chinees |
| DuckDuckBot | DuckDuckGo | Webpagina’s indexeren voor privacygerichte zoekopdrachten | Respectvol crawlen met nadruk op privacy | Minimale gegevensverzameling, respecteert privacyvoorkeuren van gebruikers |
| YandexBot | Yandex | Webpagina’s indexeren voor Yandex Zoeken | Gedistribueerd crawlen met regionale optimalisatie | Geoptimaliseerd voor Russische en Oost-Europese inhoud |
Website-eigenaren hebben verschillende hulpmiddelen en strategieën tot hun beschikking om te optimaliseren hoe spinnen hun inhoud crawlen en indexeren. Het maken van een uitgebreid sitemap.xml-bestand geeft spinnen een duidelijke routekaart van alle pagina’s die moeten worden geïndexeerd, wat de crawlefficiëntie aanzienlijk verbetert en ervoor zorgt dat er geen belangrijke pagina’s worden gemist. Het optimaliseren van meta-tags, inclusief titeltags en metabeschrijvingen, helpt spinnen de paginainhoud te begrijpen en verbetert hoe pagina’s in zoekresultaten verschijnen. Het implementeren van een goed gestructureerd robots.txt-bestand stelt website-eigenaren in staat spinnen naar belangrijke inhoud te leiden en weg te houden van pagina’s die niet geïndexeerd mogen worden, zoals beheerpanelen of dubbele inhoud. Regelmatig bijwerken en toevoegen van nieuwe inhoud moedigt spinnen aan websites vaker te herbezoeken, waardoor indexen actueel blijven en de zichtbaarheid in zoekresultaten verbetert. Website-eigenaren moeten er ook voor zorgen dat hun sitearchitectuur helder en logisch is, met een duidelijke hiërarchische navigatie die het voor spinnen gemakkelijk maakt alle pagina’s te ontdekken. Het verbeteren van de laadsnelheid van pagina’s is cruciaal omdat spinnen een beperkt crawlbudget hebben—de hoeveelheid middelen die zoekmachines toewijzen aan het crawlen van een specifieke site—en snellere pagina’s spinnen in staat stellen meer inhoud binnen dat budget te crawlen.
Ondanks hun geavanceerdheid staan webspinnen voor talrijke technische uitdagingen die hun doeltreffendheid kunnen beperken. Dynamische inhoud die door JavaScript wordt gegenereerd, vormt een aanzienlijke hindernis, omdat niet alle spinnen JavaScript-code kunnen uitvoeren om pagina’s weer te geven zoals gebruikers ze zien. Rate limiting die door websites wordt opgelegd, beperkt hoeveel verzoeken spinnen binnen een bepaald tijdsbestek kunnen doen, wat een volledige indexering van grote websites kan verhinderen. CAPTCHA-uitdagingen en andere anti-botmaatregelen kunnen de toegang van spinnen tot inhoud blokkeren, hoewel legitieme zoekmachinespinnen doorgaans op een whitelist staan. Dubbele inhoud over meerdere URL’s brengt spinnen in verwarring over welke versie moet worden geïndexeerd en gerangschikt, wat de zichtbaarheid in zoekresultaten kan verzwakken. Crawlervallen—opzettelijke of per ongeluk ontstane oneindige lussen in de websitestructuur—kunnen middelen van spinnen verspillen en crawlbudgetten opslokken zonder productieve indexering. Bovendien betekent de exponentiële groei van webinhoud dat spinnen onmogelijk alles kunnen crawlen en indexeren, waardoor geavanceerde algoritmen nodig zijn om te prioriteren welke inhoud het belangrijkst is om te indexeren. Met een wachtwoord beveiligde pagina’s en inhoud waarvoor inloggen vereist is, blijven grotendeels ontoegankelijk voor openbare spinnen, wat de indexering van privé- of lidmaatschapsinhoud beperkt.
Webspidertechnologie blijft zich snel ontwikkelen naarmate het internet groeit en complexer wordt. Moderne spinnen zijn steeds beter in staat geavanceerde webtechnologieën te verwerken, waaronder single-page applicaties, progressive web apps en het renderen van dynamische inhoud. Kunstmatige intelligentie en machine learning worden geïntegreerd in spinnenalgoritmen om de context van inhoud, de intentie van gebruikers en de kwaliteit van pagina’s beter te begrijpen. De opkomst van generatieve AI heeft nieuwe eisen aan webcrawling gecreëerd, omdat AI-systemen constant bijgewerkte, relevante en nauwkeurige informatie nodig hebben om effectief te functioneren. Enterprise-webcrawlers zijn steeds geavanceerder geworden, waardoor bedrijven hun eigen websites kunnen crawlen voor interne zoekfunctionaliteit, contentbeheer en prestatiemonitoring. De focus op crawlefficiëntie is verscherpt naarmate websites groter en complexer worden, waarbij spinnen nu slimmere prioriteringsalgoritmen implementeren om de waarde van elk crawlverzoek te maximaliseren. Privacyoverwegingen vormen ook de ontwikkeling van spinnen, met meer nadruk op het respecteren van de privacy van gebruikers terwijl effectieve inhoudsontdekking en indexering mogelijk blijft. Vooruitkijkend zullen webspinnen waarschijnlijk nog intelligenter en efficiënter worden en gebruikmaken van geavanceerde technologieën om te navigeren door een steeds complexer digitaal landschap, met respect voor websitebeleid en gebruikersprivacy.
Net zoals webspinnen systematisch het hele web doorzoeken en indexeren, volgt en optimaliseert PostAffiliatePro systematisch elke affiliaatrelatie in je netwerk. Onze geavanceerde trackingtechnologie zorgt ervoor dat geen enkele commissie ongeregistreerd blijft en geen enkele kans wordt gemist.
Leer hoe webcrawlers werken, van seed-URL's tot indexering. Begrijp het technische proces, de verschillende typen crawlers, robots.txt-regels en hoe crawlers SE...
Een spider van een zoekmachine is een geautomatiseerde bot die webpagina's crawlt om inhoud te indexeren voor zoekmachines zoals Google en Bing. Lees hoe ze wer...
Leer wat de Google Spider (Googlebot) is, hoe deze websites crawlt en indexeert, en waarom dit essentieel is voor SEO. Ontdek hoe je jouw site kunt optimalisere...
Sluit u aan bij onze gemeenschap van tevreden klanten en bied uitstekende klantenservice met Post Affiliate Pro.


Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.