


Waarom is statistische significantie belangrijk?
Ontdek waarom statistische significantie van belang is bij data-analyse, onderzoek en zakelijke beslissingen. Leer over p-waarden, hypothesetoetsing en hoe je r...
10 min lezen
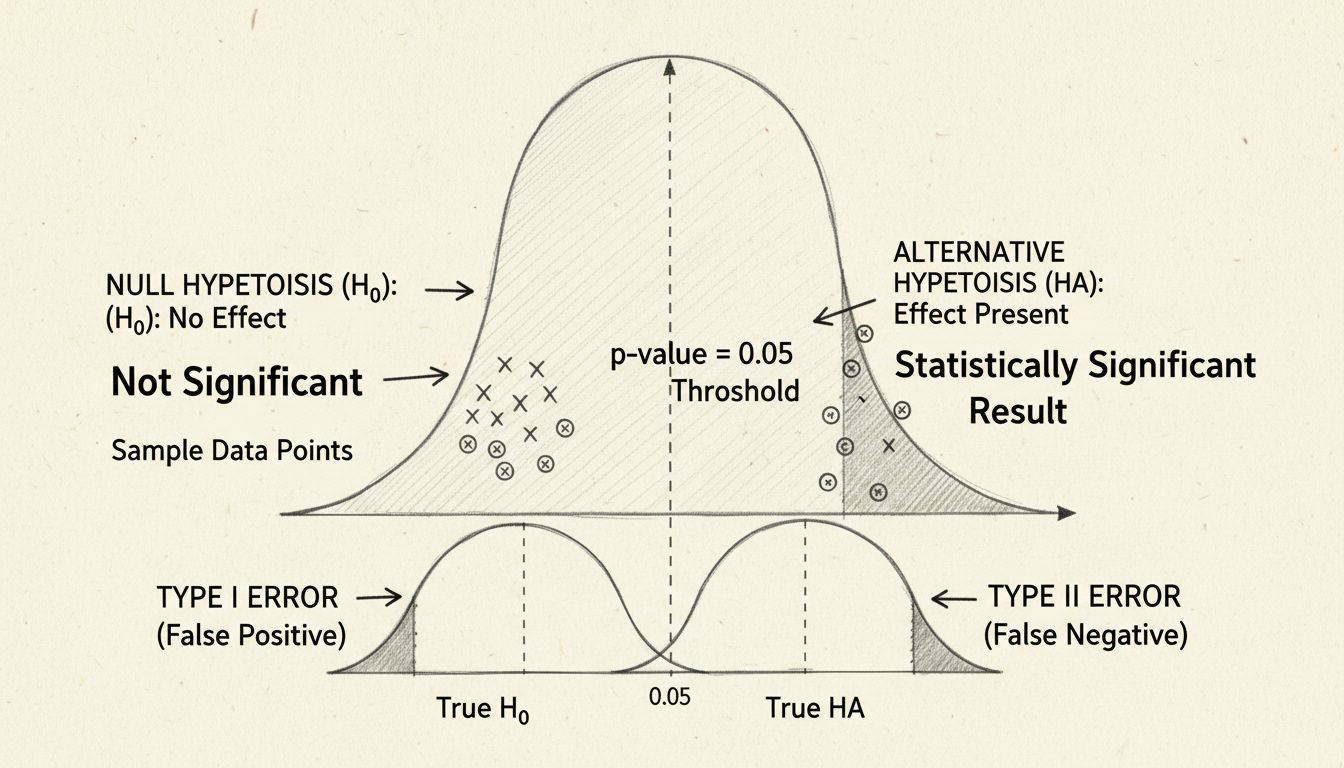
Statistische significantie is de waarschijnlijkheid dat een verband tussen twee of meer variabelen wordt veroorzaakt door iets anders dan toeval.
Op deze pagina
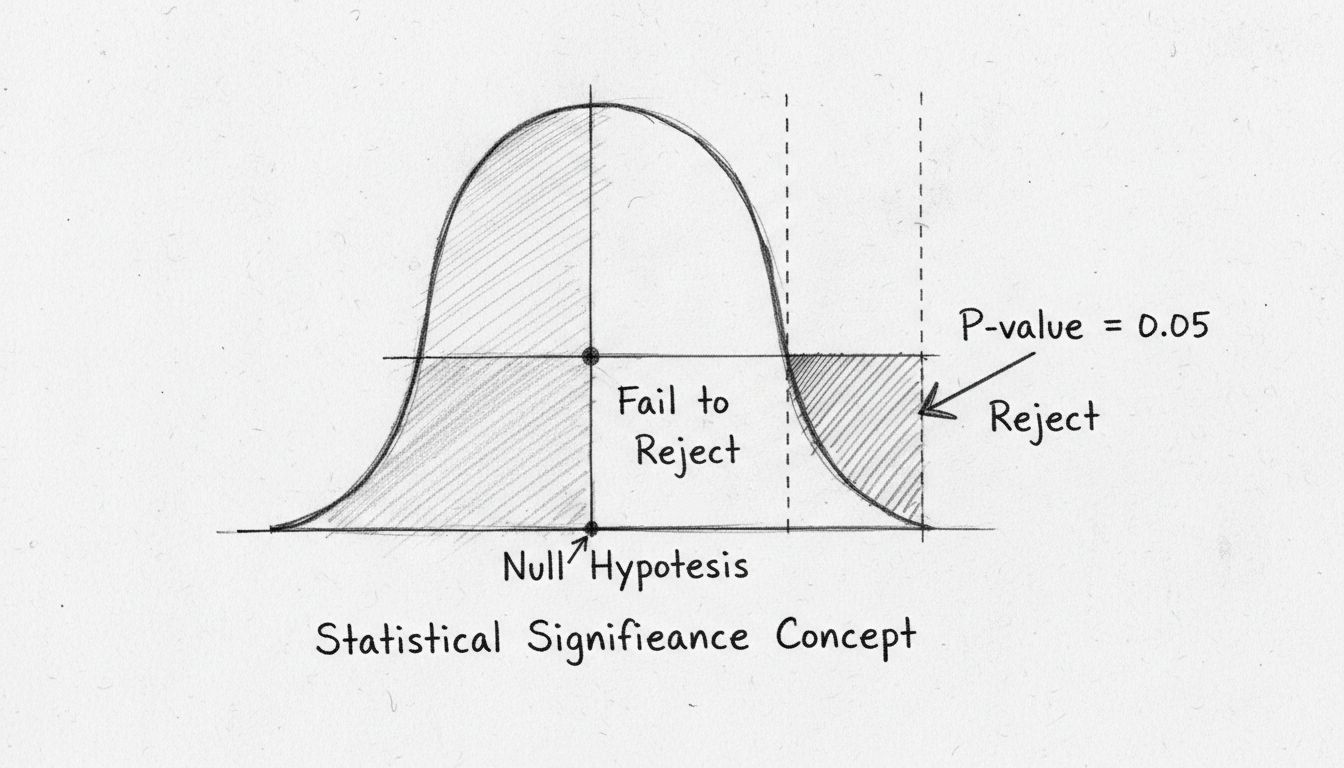
Statistische significantie is de waarschijnlijkheid dat een verband tussen twee of meer variabelen wordt veroorzaakt door iets anders dan toeval. In formele termen is het de kans dat een waargenomen verschil — of een extremer verschil — zou optreden als de nulhypothese (de aanname van geen echt effect) waar zou zijn.
Elke dataset bevat willekeurige variatie — de natuurlijke fluctuatie die optreedt, zelfs wanneer er geen onderliggend effect bestaat. Gooi een zuivere munt 100 keer op en u zult zelden precies 50 keer kop krijgen. Die afwijking is willekeurige ruis, geen bewijs dat de munt gemanipuleerd is.
Statistische significantie kwantificeert of de afwijking die u ziet groot genoeg is, in verhouding tot uw steekproefomvang, om onwaarschijnlijk te zijn onder alleen willekeurige ruis. Wanneer dat het geval is, kunt u de nulhypothese verwerpen en concluderen dat er waarschijnlijk een echt effect bestaat.
Twee gerelateerde concepten helpen hierbij:
Stel dat u een online winkel beheert en twee versies van een productpagina test. Versie A converteert op 4,2%. Versie B converteert op 4,8%. Dat is een verschil van 0,6 procentpunt — maar is het echt?
U voert een statistische toets uit. Deze geeft een p-waarde van 0,03.
Als de p-waarde echter 0,30 was geweest, zou dezelfde kloof volledig consistent zijn met toeval — en erop handelen zou voorbarig zijn.

Stel geavanceerde tracking in binnen enkele minuten. Geen creditcard vereist.
Elke significantietoets begint met twee tegenovergestelde uitspraken:
De toets bewijst H₁ niet direct. Het biedt alleen een maatstaf voor hoe onwaarschijnlijk de gegevens zouden zijn als H₀ waar was. Als die onwaarschijnlijkheid klein genoeg is, verwerpen we H₀ ten gunste van H₁.
Dit raamwerk is direct van toepassing op A/B-testen.
Veelvoorkomende misinterpretaties om te vermijden:
Het significantieniveau, aangeduid met α (alfa), is de drempel die u instelt voordat u een toets uitvoert. Het vertegenwoordigt uw tolerantie voor vals-positieven — het verwerpen van de nulhypothese terwijl deze eigenlijk waar is. Dit wordt ook wel een Type I-fout genoemd.
| Drempelwaarde | Betekenis | Risico op vals-positief |
|---|---|---|
| α = 0,05 | Standaard in de meeste vakgebieden | 5% (1 op 20) |
| α = 0,01 | Strenger; gebruikt wanneer vals-positieven kostbaar zijn | 1% (1 op 100) |
| α = 0,001 | Zeer streng; beslissingen met grote gevolgen | 0,1% (1 op 1.000) |
Als p < α, is het resultaat statistisch significant op dat niveau.
Een betrouwbaarheidsinterval geeft een reeks plausibele waarden voor de werkelijke effectgrootte. Een 95%-betrouwbaarheidsinterval betekent: als u de studie 100 keer zou herhalen, zouden ongeveer 95 van die intervallen de werkelijke waarde bevatten.
Smallere intervallen duiden op preciezere schattingen — meestal het gevolg van grotere steekproeven. In bedrijfscontexten zijn betrouwbaarheidsintervallen vaak informatiever dan p-waarden alleen, omdat ze de omvang en richting van een effect laten zien, niet alleen of het bestaat.
Ja — in de meeste toegepaste vakgebieden is p < 0,05 de standaard voor het claimen van statistische significantie. Deze conventie gaat terug op het werk van Ronald Fisher in de jaren 1920, en hoewel enigszins willekeurig, is ze blijven bestaan omdat ze twee risico’s in evenwicht brengt: vals-positieven (Type I-fouten) en vals-negatieven (Type II-fouten, waarbij een echt effect wordt gemist).
Een p-waarde van 0,01 is statistisch significanter dan 0,05 omdat het een lagere kans aangeeft dat het waargenomen resultaat aan toeval te wijten is. Bij α = 0,01 accepteert u slechts een risico van 1% op een vals-positief, vergeleken met 5% bij α = 0,05.
Een lagere p-waarde betekent echter niet automatisch een groter of belangrijker effect. Met een enorme steekproef kan zelfs een triviaal klein verschil p < 0,001 opleveren. Daarom moeten effectgrootte en praktische significantie samen met de p-waarde worden geëvalueerd.
Een p-waarde onder 0,001 betekent dat het waargenomen resultaat door toeval zou optreden in minder dan 1 op de 1.000 keer als de nulhypothese waar zou zijn. Dit is sterk bewijs tegen de nulhypothese — maar het garandeert nog steeds geen praktisch belang.
Wees de eerste die op de hoogte is van nieuwe functies en productupdates.
Steekproefomvang is de meest invloedrijke factor. Grotere steekproeven verminderen de impact van willekeurige variatie, waardoor echte verschillen gemakkelijker te detecteren zijn. Dit is waarom een conversiestijging van 2% significant kan zijn met 50.000 bezoekers maar niet met 500.
Voor sites met weinig verkeer betekent dit dat tests langer moeten duren of gericht moeten zijn op veranderingen met grotere effecten.
Effectgrootte meet de omvang van het waargenomen verschil — niet alleen of het bestaat. Een grote effectgrootte (bijv. een conversiestijging van 30%) bereikt sneller significantie en met kleinere steekproeven. Een kleine effectgrootte (bijv. 0,5%) vereist enorme steekproeven om betrouwbaar te detecteren.
Dit is waar de relatie tussen statistische significantie en praktische significantie cruciaal wordt. Een bevinding kan statistisch significant zijn maar praktisch irrelevant als het effect te klein is om uit te maken voor bedrijfsbeslissingen.
Geen enkele statistische toets kan slechte gegevens compenseren. Veelvoorkomende datakwaliteitsproblemen zijn:
Voordat u statistische significantie berekent, moet u verifiëren dat uw gegevensverzameling schoon, consistent en vrij van systematische vertekening is. Een significant resultaat op basis van gebrekkige gegevens is slechter dan helemaal geen resultaat.
Statistische power is de kans dat een toets een echt effect detecteert wanneer dit bestaat. Het is het complement van het Type II-foutpercentage (β).
Power hangt af van steekproefomvang, effectgrootte en het gekozen significantieniveau. Ondergepowerde studies zijn een veelvoorkomende reden waarom ogenschijnlijk veelbelovende A/B-testresultaten niet repliceerbaar blijken.
Verschillende gegevenstypen vereisen verschillende toetsen:
| Toets | Gebruikssituatie | Voorbeeld |
|---|---|---|
| T-toets | Vergelijken van gemiddelden van twee groepen | Conversieratio’s: versie A vs. versie B |
| Chi-kwadraattoets | Vergelijken van categorische frequenties | Doorklikratio’s bij meerdere advertentie-uitingen |
| Z-toets | Vergelijken van verhoudingen met grote steekproeven | Conversieverhoudingen van landingspagina’s |
| ANOVA | Vergelijken van gemiddelden van drie of meer groepen | Prestaties van meerdere affiliate partners |
U hoeft statistische significantie niet handmatig te berekenen. Veelgebruikte hulpmiddelen zijn:
De meeste hulpmiddelen rapporteren zowel de p-waarde als het betrouwbaarheidsinterval. Controleer altijd beide voordat u een beslissing neemt.
Statistische significantie is niet alleen een academisch concept. In affiliate marketing, waar commissies, budgetten en partnerrelaties afhankelijk zijn van prestatiegegevens, is het een praktische waarborg tegen kostbare misvattingen.
Adverteerders die affiliateprogramma’s beheren, testen routinematig landingspagina’s, aanbodstructuren en creatieve uitingen. Statistische significantie zorgt ervoor dat beslissingen over welke versie moet worden opgeschaald, gebaseerd zijn op echte prestatieverschillen, niet op willekeurige fluctuaties.
Voorbeeld werkwijze: Een adverteerder test twee commissiestructuren — een vast tarief van 10% versus een getrapt model van 5%/12%/18%. Na 30 dagen en 5.000 transacties toont het getrapte model een 22% hogere gemiddelde orderwaarde. Een t-toets geeft p = 0,02. De adverteerder kan het getrapte model met vertrouwen uitrollen, wetende dat het waargenomen verschil waarschijnlijk geen willekeurige ruis is.
Zonder significantietoetsing had de adverteerder de wijziging mogelijk doorgevoerd op basis van een kortetermijnfluctuatie — en mogelijk de partnerinkomsten verlaagd als het effect was omgedraaid.
Uitgevers (affiliates) nemen beslissingen over welke producten te promoten, in welke verkeersbronnen te investeren en welke contentformaten het beste converteren. Elk van deze beslissingen profiteert van significantietoetsing.
Voorbeeld werkwijze: Een uitgever test twee versies van een recensieartikel — één met een vergelijkingstabel bovenaan, één met de tabel onderaan. Bij 10.000 paginaweergaven genereert de versie met de tabel bovenaan een doorklikratio van 3,1% naar de handelaar versus 2,6% voor de versie met de tabel onderaan. Een chi-kwadraattoets geeft p = 0,04. De uitgever neemt het formaat met de tabel bovenaan over en past het patroon toe op andere recensies.
Programmabeheerders evalueren partnerprestaties, stellen commissieniveaus in en beslissen welke affiliates te werven of te behouden. Statistische significantie helpt onderscheid te maken tussen consistent hoogpresterende partners en partners wiens goede maanden slechts variatie zijn.
Voorbeeld werkwijze: Een programmabeheerder vergelijkt twee affiliates met vergelijkbare verkeersvolumes. Affiliate A heeft een conversieratio van 5,2% over 12 maanden; Affiliate B heeft 4,1%. Een tweesteekproefs z-toets bevestigt dat het verschil significant is (p = 0,008). De beheerder gebruikt deze gegevens om hogere commissieniveaus toe te wijzen aan Affiliate A en te onderzoeken wat Affiliate B kan verbeteren.
In alle drie de rollen is het principe hetzelfde: laat de gegevens significantie bereiken voordat u handelt. Voorbarige beslissingen — commissies verhogen voor een partner die één goede maand had, of een landingspagina verlaten die één slechte week had — behoren tot de meest voorkomende en vermijdbare fouten in affiliate marketing.
Dit is het hardnekkigste misverstand. Een resultaat kan statistisch significant zijn met p < 0,001 en toch te klein zijn om ertoe te doen. In een bekend voorbeeld uit het NIST-engineeringstatistiekhandboek was een productieprocesverbetering statistisch significant, maar leverde slechts een winst van 0,2 eenheden op — ver onder de drempel van praktische waarde.
Stel altijd twee vragen:
P-hacking verwijst naar de praktijk van het uitvoeren van meerdere analyses en het selectief rapporteren van alleen die welke significantie bereiken. Veelvoorkomende vormen zijn:
Deze praktijken verhogen het percentage vals-positieven drastisch.
De les voor zakelijke gebruikers: registreer uw testplan vooraf, houd u aan één primaire metriek en weersta de verleiding om te vissen naar significantie.
Statistische significantie is minder nuttig — of ronduit misleidend — in deze scenario’s:
Benut statistische significantie om uw campagnes te optimaliseren, conversieratio's te verbeteren en slimmere marketingbeslissingen te nemen.
Ontdek waarom statistische significantie van belang is bij data-analyse, onderzoek en zakelijke beslissingen. Leer over p-waarden, hypothesetoetsing en hoe je r...
Ontdek hoe statistische significantie bepaalt of resultaten echt zijn of toeval. Begrijp p-waarden, hypothesetoetsing en praktische toepassingen voor uw bedrijf...
Beheers statistische significantie in A/B-testen voor betting affiliate campagnes.
Sluit u aan bij onze gemeenschap van tevreden klanten en bied uitstekende klantenservice met Post Affiliate Pro.


Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.