

Hoe los je problemen met dubbele content op: Complete SEO-gids
Leer bewezen methoden om problemen met dubbele content op te lossen, waaronder 301-omleidingen, canonieke tags en noindex-richtlijnen. Bescherm je SEO-rankings ...
12 min lezen
Dubbele content zijn substantiële blokken tekst, code of media die op meer dan één plek op internet voorkomen — wat betekent dat twee of meer verschillende URL’s hetzelfde of grotendeels vergelijkbaar materiaal leveren aan gebruikers en zoekmachines.
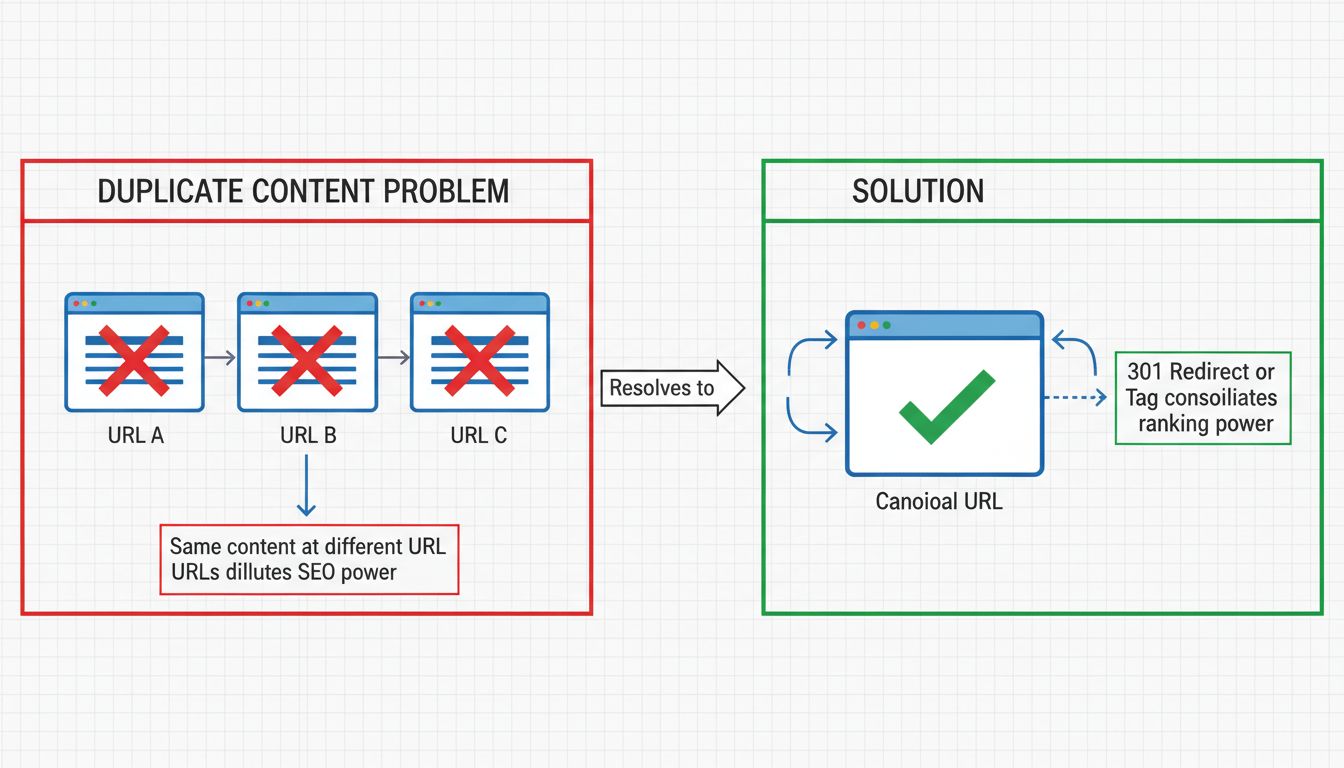
Dubbele content zijn substantiële blokken tekst, code of media die op meer dan één plek op internet voorkomen — wat betekent dat twee of meer verschillende URL’s hetzelfde of grotendeels vergelijkbaar materiaal leveren aan gebruikers en zoekmachines. Wanneer Google, Bing of een andere crawler dezelfde content op meerdere webadressen tegenkomt, moet deze beslissen welke versie te indexeren, welke te ranken en welke te negeren. Die beslissing is niet altijd degene die jij zelf zou nemen.
Inzicht in dubbele content is belangrijk voor iedereen die een website beheert, een affiliateprogramma runt of online content publiceert. Onaangepakt splitst het rankingsignalen, verspilt het crawlbudget en verwart het de zoekmachines waar je afhankelijk van bent voor verkeer.
Dubbele content betekent dat dezelfde of grotendeels vergelijkbare content op meer dan één URL leeft. Die URL’s kunnen tot hetzelfde domein behoren (interne duplicatie) of zich over volledig verschillende websites uitstrekken (externe duplicatie).
Een pagina kwalificeert als duplicaat wanneer deze merkbare overlap vertoont in formulering, structuur en kernboodschap met een andere pagina, weinig tot geen originele informatie toevoagt en geen betekenisvolle waarde biedt die verder gaat dan wat de andere versie al biedt. Koppen, voetteksten en navigatie-elementen die zich over een site herhalen, tellen niet mee — zoekmachines begrijpen dat die deel uitmaken van een sjabloon, niet van de inhoudelijke content zelf.
Interne duplicatie vindt plaats binnen één enkel domein. Veelvoorkomende scenario’s zijn:
example.com/product als example.com/product?color=blueElk van deze creëert een apart adres voor dezelfde onderliggende content. Zoekmachines zien meerdere URL’s die strijden om dezelfde zoekopdracht, en ze belonen zelden allemaal.
Externe duplicatie treedt op wanneer content van het ene domein op een ander verschijnt. Dit kan kwaadaardig zijn — content die zonder toestemming is geschraapt en opnieuw gepubliceerd — of volledig legitiem, zoals bij gesyndiceerde artikelen die naar partnersites worden verspreid. Zonder een canonieke tag die terugverwijst naar het origineel, kunnen zoekmachines de kopie boven de bron ranken, of rankingsignalen tussen beide splitsen.
Niet alle dubbele content is identiek. Bijna-dubbele content deelt dezelfde structuur en kernboodschap, maar varieert in kleine details: een productpagina waarbij alleen de kleurnaam verandert, een servicegebiedpagina waarbij alleen de stad verschilt, of een vertaalde versie van hetzelfde artikel. Google behandelt deze als duplicaten wanneer de verschillen te klein zijn om een aparte pagina te rechtvaardigen. De drempel is geen vast percentage — het gaat erom of elke pagina werkelijk onderscheidende waarde biedt aan een zoeker.

Stel geavanceerde tracking in binnen enkele minuten. Geen creditcard vereist.
Dubbele content creëert drie concrete problemen voor zowel zoekmachines als site-eigenaren.
Wanneer meerdere URL’s dezelfde content leveren, moeten zoekmachines er één kiezen om in hun index op te slaan. Ze kunnen de verkeerde kiezen — een niet-geoptimaliseerde, parameter-beladen URL in plaats van de schone canonieke versie. De andere versies kunnen volledig worden gedropt, wat betekent dat de pagina die je gerankt wilt zien nooit in zoekresultaten verschijnt.
Backlinks behoren tot de sterkste rankingsignalen. Wanneer externe sites naar verschillende versies van dezelfde content linken — sommige naar de HTTP-versie, sommige naar HTTPS, sommige met een slash aan het einde en sommige zonder — wordt de autoriteit die die links dragen verdeeld over meerdere URL’s in plaats van geconcentreerd op één. Een pagina die op positie drie had kunnen ranken, staat misschien op positie twaalf omdat de linkwaarde is versnipperd over vier dubbele URL’s.
Zoekmachines wijzen een beperkte hoeveelheid tijd en middelen toe aan het crawlen van een bepaalde site. Elke dubbele URL die een crawler verwerkt, is een unieke, waardevolle pagina minder die het in die sessie kan ontdekken en indexeren. Op grote sites — e-commercewinkels met duizenden SKU’s, affiliate-contenthubs met dynamisch gegenereerde pagina’s — kan verspilling van crawlbudget door duplicaten de zichtbaarheid van echt belangrijke pagina’s onderdrukken.
Nee — niet in de zin van een handmatige straf. De meeste dubbele content op het web is onbedoeld, niet misleidend, en Google’s systemen houden daar rekening mee.
Het onderscheid is belangrijk. Google onderneemt wel actie tegen opzettelijk manipulerende duplicatie: sites die content op schaal schrapen en opnieuw publiceren uitsluitend om zoekverkeer aan te trekken, of die duizenden bijna-identieke doorway-pagina’s genereren volgepropt met trefwoorden. In die gevallen kan Google een handmatige actie of algoritmische onderdrukking toepassen. Maar voor de gewone website-eigenaar met een handvol parameter-gedreven dubbele URL’s is het gevolg geen straf — het is de verloren kans van gesplitste signalen en verdunde rankings.
Het praktische resultaat is vergelijkbaar: je content presteert minder. Maar begrijpen dat dit een algoritmisch filtereffect is in plaats van een bestraffende maatregel helpt je om oplossingen correct te prioriteren. Je bent niet in een race om een straf te ontlopen; je consolideert kracht die al van jou is.
Wees de eerste die op de hoogte is van nieuwe functies en productupdates.
De meeste dubbele content wordt onbedoeld gecreëerd, door de manier waarop contentmanagementsystemen, e-commerceplatforms en sitearchitecturen standaard werken.
Trackingparameters (?utm_source=, ?session_id=), sorteermogelijkheden (?sort=price) en filtercombinaties genereren unieke URL’s voor wat in wezen dezelfde pagina is. Een enkele productpagina op een e-commercesite kan tientallen geparametriseerde URL’s voortbrengen, die elk afzonderlijk worden geïndexeerd tenzij ze worden beheerd.
Als je site toegankelijk is via zowel http://example.com als https://example.com, of via zowel https://www.example.com als https://example.com, heb je ten minste twee versies van elke pagina. Zonder een site-brede redirect van de ene naar de andere, kunnen beide versies worden gecrawld en geïndexeerd.
example.com/page en example.com/page/ kunnen dezelfde content weergeven maar als verschillende URL’s registreren. De meeste moderne CMS-platforms handelen dit automatisch af, maar verkeerd geconfigureerde servers kunnen beide blootstellen.
Aparte URL’s voor print-geoptimaliseerde of AMP-versies van artikelen creëren duplicaten van de hoofdcontent. Als deze alternatieve versies indexeerbaar zijn, concurreren ze met het origineel.
Wanneer andere sites je content kopiëren — met of zonder toestemming — creëren ze externe duplicaten. Zelfs legitieme syndicatiepartners hebben canonieke tags nodig die naar jouw origineel verwijzen; anders kan hun herpubliceerde versie hoger ranken dan de jouwe.
Fabrikanten leveren vaak dezelfde productbeschrijving aan honderden detailhandelaren en affiliates. Wanneer elke verkoper die identieke tekst publiceert, zien zoekmachines massale duplicatie over domeinen heen.
E-commerce- en listingsites die gebruikers laten filteren op maat, kleur, prijsklasse of beoordeling, creëren een combinatorische URL-explosie. Een categoriepagina met vijf filteropties, elk met vijf waarden, kan meer dan 3.000 unieke URL’s genereren — die allemaal grotendeels hetzelfde productraster tonen.
Stagingsites die per ongeluk indexeerbaar blijven, dupliceren de gehele productiesite. Een verkeerde configuratie van robots.txt of een ontbrekende noindex-tag op een dev-server kan ertoe leiden dat de hele site wordt gespiegeld in zoekresultaten.
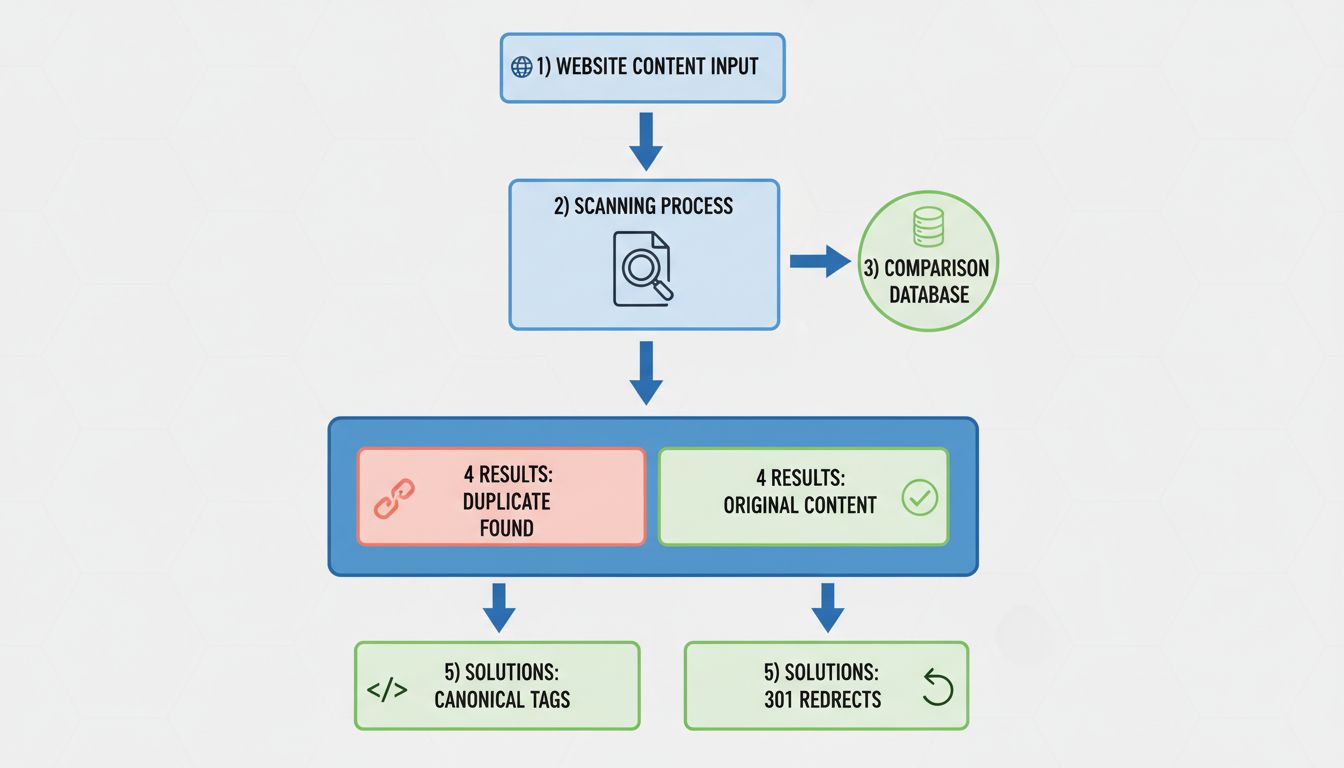
Voordat je dubbele content kunt oplossen, moet je weten waar het zich bevindt. Verschillende methoden en tools maken dit eenvoudig.
Dit is de snelste, meest gezaghebbende manier om duplicatie te ontdekken die al van invloed is op je rankings.
Speciale SEO-crawlers — Screaming Frog, Sitebulb, Ahrefs Site Audit, Semrush Site Audit — crawlen je hele site en markeren pagina’s met dubbele titels, dubbele meta-omschrijvingen en bijna-identieke bodycontent. Screaming Frog’s rapport “Dubbele Pagina’s” groepeert URL’s bijvoorbeeld op content-hash en laat precies zien welke pagina’s dezelfde of bijna-identieke content delen. De meeste van deze tools bieden gratis versies die voldoende zijn voor kleine tot middelgrote sites.
Kopieer een onderscheidende zin uit je content — tussen aanhalingstekens — en plak deze in Google. De resultaten tonen elke geïndexeerde pagina die die exacte zin bevat. Als je URL’s ziet die je niet verwachtte, heb je externe duplicaten gevonden of interne pagina’s waarvan je niet wist dat ze waren geïndexeerd.
Tools zoals Copyscape en Siteliner vergelijken je content met het web in het algemeen en met andere pagina’s op je eigen domein. Copyscape is bijzonder nuttig voor het vinden van sites die je content zonder toestemming hebben geschraapt. Siteliner scant interne duplicatiepercentages op je domein.
Controleer of je site toegankelijk is via meerdere protocol- en subdomeinvarianten. Open http://jousite.nl, https://jousite.nl, http://www.jousite.nl en https://www.jousite.nl. Als meer dan één naar een live pagina verwijst in plaats van door te sturen, heb je een systematisch probleem met dubbele content dat elke pagina treft.
Het oplossen van dubbele content betekent dat je zoekmachines vertelt welke versie van een pagina je gerankt wilt hebben, en alle signalen daarachter consolideert.
Een 301-redirect stuurt gebruikers en zoekmachines permanent van een dubbele URL naar de canonieke versie. Dit is het sterkste signaal dat je kunt sturen: het consolideert linkwaarde, verwijdert het duplicaat na verloop van tijd uit de index en zorgt ervoor dat bezoekers altijd op de juiste pagina belanden.
Gebruik 301-redirects wanneer:
<link rel="canonical" href="https://example.com/original-page/" />
Canonieke tags zijn het juiste hulpmiddel wanneer:
In tegenstelling tot een redirect verwijdert een canonieke tag het dubbele URL niet — het geeft alleen een voorkeur aan. Zoekmachines behandelen het als een sterke hint, niet als een absoluut bevel.
Een noindex-tag instrueert zoekmachines om een pagina helemaal niet in hun index op te nemen. Gebruik het op pagina’s die een doel dienen voor gebruikers maar nooit in zoekresultaten mogen verschijnen: bedankpagina’s, interne zoekresultaatpagina’s, printervriendelijke versies en staging-omgevingen.
<meta name="robots" content="noindex" />
Combineer noindex met follow als je nog steeds wilt dat linkwaarde via de pagina naar andere bestemmingen stroomt.
Elke keer dat je naar een pagina op je eigen site linkt, gebruik je exact dezelfde URL-indeling. Als je canonieke versie https://example.com/page/ is, link dan niet naar https://www.example.com/page of http://example.com/page/ in je navigatie, bodycontent of voettekst. Inconsistentie in je eigen verwijzingen stuurt gemengde signalen die je canonieke keuzes ondermijnen.
De tool URL-Parameters van Google Search Console (onder Verouderde Tools) laat je Google vertellen hoe het met specifieke parameters moet omgaan. Je kunt aangeven dat ?sort= of ?session_id= de paginacontent niet verandert, wat Google helpt om geparametriseerde URL’s onder de canonieke versie te consolideren. Gebruik dit voorzichtig — verkeerde configuratie kan ertoe leiden dat Google parameters negeert die wel degelijk betekenisvol verschillende content opleveren.
De meest duurzame oplossing voor dubbele content is het maken van pagina’s die werkelijk onderscheidend zijn. Voor affiliate marketeers betekent dit het schrijven van originele productrecensies, vergelijkingen en handleidingen in plaats van fabrikantbeschrijvingen opnieuw te publiceren. Voor e-commercesites betekent het het toevoegen van unieke productfotografie, klantvragen en antwoorden, en originele aankoopgidsen. Zoekmachines belonen content die waarde toevoegt die verder gaat dan wat elders al bestaat.
Affiliate marketeers staan voor een unieke uitdaging met dubbele content: ze promoten producten die honderden of duizenden andere affiliates ook promoten, vaak met dezelfde door fabrikanten geleverde beschrijvingen, afbeeldingen en specificaties.
Wanneer een affiliate een productbeschrijving van de site van de handelaar kopieert en deze letterlijk publiceert, voegen ze zich bij een pool van identieke pagina’s die strijden om dezelfde zoekwoorden. Google ziet tientallen of honderden pagina’s met dezelfde tekst en moet er één — of geen — kiezen om te ranken. De eigen productpagina van de handelaar, met zijn hogere domeinautoriteit, wint bijna altijd. De pagina van de affiliate zakt weg.
Dit is geen straf. Het is een relevantie- en autoriteitsprobleem: identieke content voegt niets nieuws toe aan het web, dus zoekmachines hebben geen reden om meerdere kopieën ervan te tonen.
Schrijf originele productrecensies. Herhaal niet de functielijst van de fabrikant, maar beschrijf je praktijkervaring met het product. Wat verraste je? Wat vond je frustrerend? Hoe verhoudt het zich tot alternatieven die je hebt getest? Details uit eerste hand kunnen door niemand anders worden gedupliceerd.
Voeg unieke waarde toe die verder gaat dan de productbeschrijving. Neem originele fotografie, videowalkthroughs, zelfgemaakte vergelijkingstabellen, gebruiksscenario’s en antwoorden op vragen die de pagina van de fabrikant niet behandelt.
Gebruik canonieke tags bij syndicatie. Als je content publiceert die ook op de site van je handelaar of een partnerblog verschijnt, voeg dan een canonieke tag toe die verwijst naar de versie die je gerankt wilt hebben. Stem met je affiliate-programmamanager af welke URL canoniek is.
Vermijd doorway-paginastrategieën. Het creëren van tientallen bijna-identieke pagina’s die mikken op kleine zoekwoordvariaties — ooit een veelgebruikte affiliate-tactiek — is uitdrukkelijk tegen de richtlijnen van Google en riskeert algoritmische onderdrukking. Eén uitgebreide pagina die een onderwerp grondig behandelt, zal beter presteren dan tien dunne variaties.
Affiliate-programmamanagers kunnen problemen met dubbele content in hun affiliate-netwerk verminderen door:
Handelaren en adverteerders die affiliateprogramma’s runnen, profiteren wanneer hun affiliates unieke, hoogwaardige content publiceren. Het vergroot het zoekbereik van het merk over meer zoekwoorden en queries dan de site van de handelaar alleen zou kunnen vastleggen. Dubbele content van affiliates daarentegen voegt geen incrementele zoekaanwezigheid toe en kan een negatieve merkindruk creëren wanneer zoekers dezelfde tekst op tientallen laagwaardige sites tegenkomen. Investeren in affiliate-educatie en unieke creatieve middelen levert een direct SEO-dividend op.
Er is geen officiële procentuele drempel waaronder dubbele content “veilig” is. Google gebruikt geen duplicatiescore die actie onderneemt bij een bepaald niveau. In plaats daarvan is de vraag of elke pagina toegevoegde waarde biedt.
De praktische maatstaf: als je niet vol vertrouwen aan een zoeker zou kunnen uitleggen waarom deze pagina apart zou moeten bestaan van vergelijkbare pagina’s op je site of elders, is deze waarschijnlijk te dun om een eigen URL te rechtvaardigen.
Vermijd problemen met dubbele content en verbeter de zoekmachine-ranking van je site. Ontdek oplossingen en best practices voor affiliate marketeers.
Leer bewezen methoden om problemen met dubbele content op te lossen, waaronder 301-omleidingen, canonieke tags en noindex-richtlijnen. Bescherm je SEO-rankings ...

Ontdek waarom dubbele content schadelijk is voor SEO, hoe het de rankings beïnvloedt en bewezen oplossingen zoals canonieke tags en 301-redirects om dubbele con...
Leer hoe je dubbele content kunt opsporen met tools als Copyscape, Siteliner en Google Search Console. Ontdek handmatige methoden, interne duplicaatdetectie en ...
Sluit u aan bij onze gemeenschap van tevreden klanten en bied uitstekende klantenservice met Post Affiliate Pro.
Cookie Toestemming
We gebruiken cookies om uw browse-ervaring te verbeteren en ons verkeer te analyseren. See our privacy policy.